La précision n'est pas une preuve, et confondre l'une avec l'autre est un seul et même piège à double visage. Poussez un modèle de risque à une précision parfaite et il ne tarifiera pas l'assurance plus équitablement ; il cessera d'assurer qui que ce soit, car une fois que chaque personne est ramenée à sa propre perte prédite, il ne reste plus d'incertitude partagée à mutualiser. Publiez un verdict de Fairness qui semble tout aussi précis, « aucune disparité détectée », et il peut toujours ne rien prouver, car ce qu'il visait est peut-être mal défini et ce qu'il a réussi à voir peut être superficiel. La granularité n'est pas l'exactitude, et un chiffre présenté avec assurance n'est pas pour autant un chiffre vrai. Il s'agit ici d'évaluer les systèmes d'IA en matière de Fairness et d'explicabilité, et des deux informations qui séparent un verdict précis d'un verdict prouvé, celles qu'une évaluation doit fournir et ne fournit presque jamais.
L'objection de l'actuaire survient généralement une vingtaine de minutes après le début d'une première réunion, une fois les amabilités échangées et que quelqu'un se sent suffisamment en confiance pour dire ce qu'il pense vraiment.
La Fairness, dit-il, est un mot vague. La tarification du risque n'est pas une défaillance morale. Tout l'intérêt de l'assurance est de distinguer les bons risques des mauvais, et si nous ne pouvions pas le faire, il n'y aurait aucun produit à vendre. Les attributs protégés sont hors de question, d'accord, personne ne le conteste. Mais au-delà de cette limite, il existe un droit légitime de facturer plus là où l'on s'attend à perdre plus. Alors, affinons le modèle. Un modèle plus précis donne un prix plus juste, pas moins juste.
L'autre objection vient des personnes qui achètent des audits, et elle est posée bien moins souvent qu'elle ne le devrait. Votre rapport indique que le modèle est équitable. Sur quoi ce verdict reposait-il ? Avez-vous vu l'intérieur du système, ou lui avez-vous envoyé quelques milliers de prompts pour lire ce qu'il a renvoyé ?
L'une traite la précision comme une vertu. L'autre la traite comme une affirmation à vérifier. Mettez les deux côte à côte et ils cessent d'être deux arguments.
À qui s'adresse ce texte
Nous définissons le public avant l'argument, par principe, car le lecteur modifie la manière dont une conclusion doit être rédigée, et prétendre le contraire est la meilleure façon de biaiser les rapports.
Celui-ci s'adresse aux personnes qui gouvernent les systèmes d'IA et à celles qui les évaluent de l'extérieur : risque et conformité, audit interne, risque de modèle, évaluateurs externes, et à toute personne au sein du conseil d'administration qui doit apposer son nom sur un document. Les ingénieurs voudront peut-être passer directement aux parties trois et quatre, qui présentent la méthode. La première partie ne nécessite aucune connaissance technique et s'adresse à quiconque s'est déjà vu proposer une prime et s'est demandé comment ce chiffre avait été calculé.
Notre position n'est pas neutre. Nous commercialisons des évaluations et avons donc un intérêt dans la norme que cet article propose. Cela a également un coût pour nous, que nous aborderons dans la septième partie.
Synthèse
Deux arguments qui n'en font qu'un.
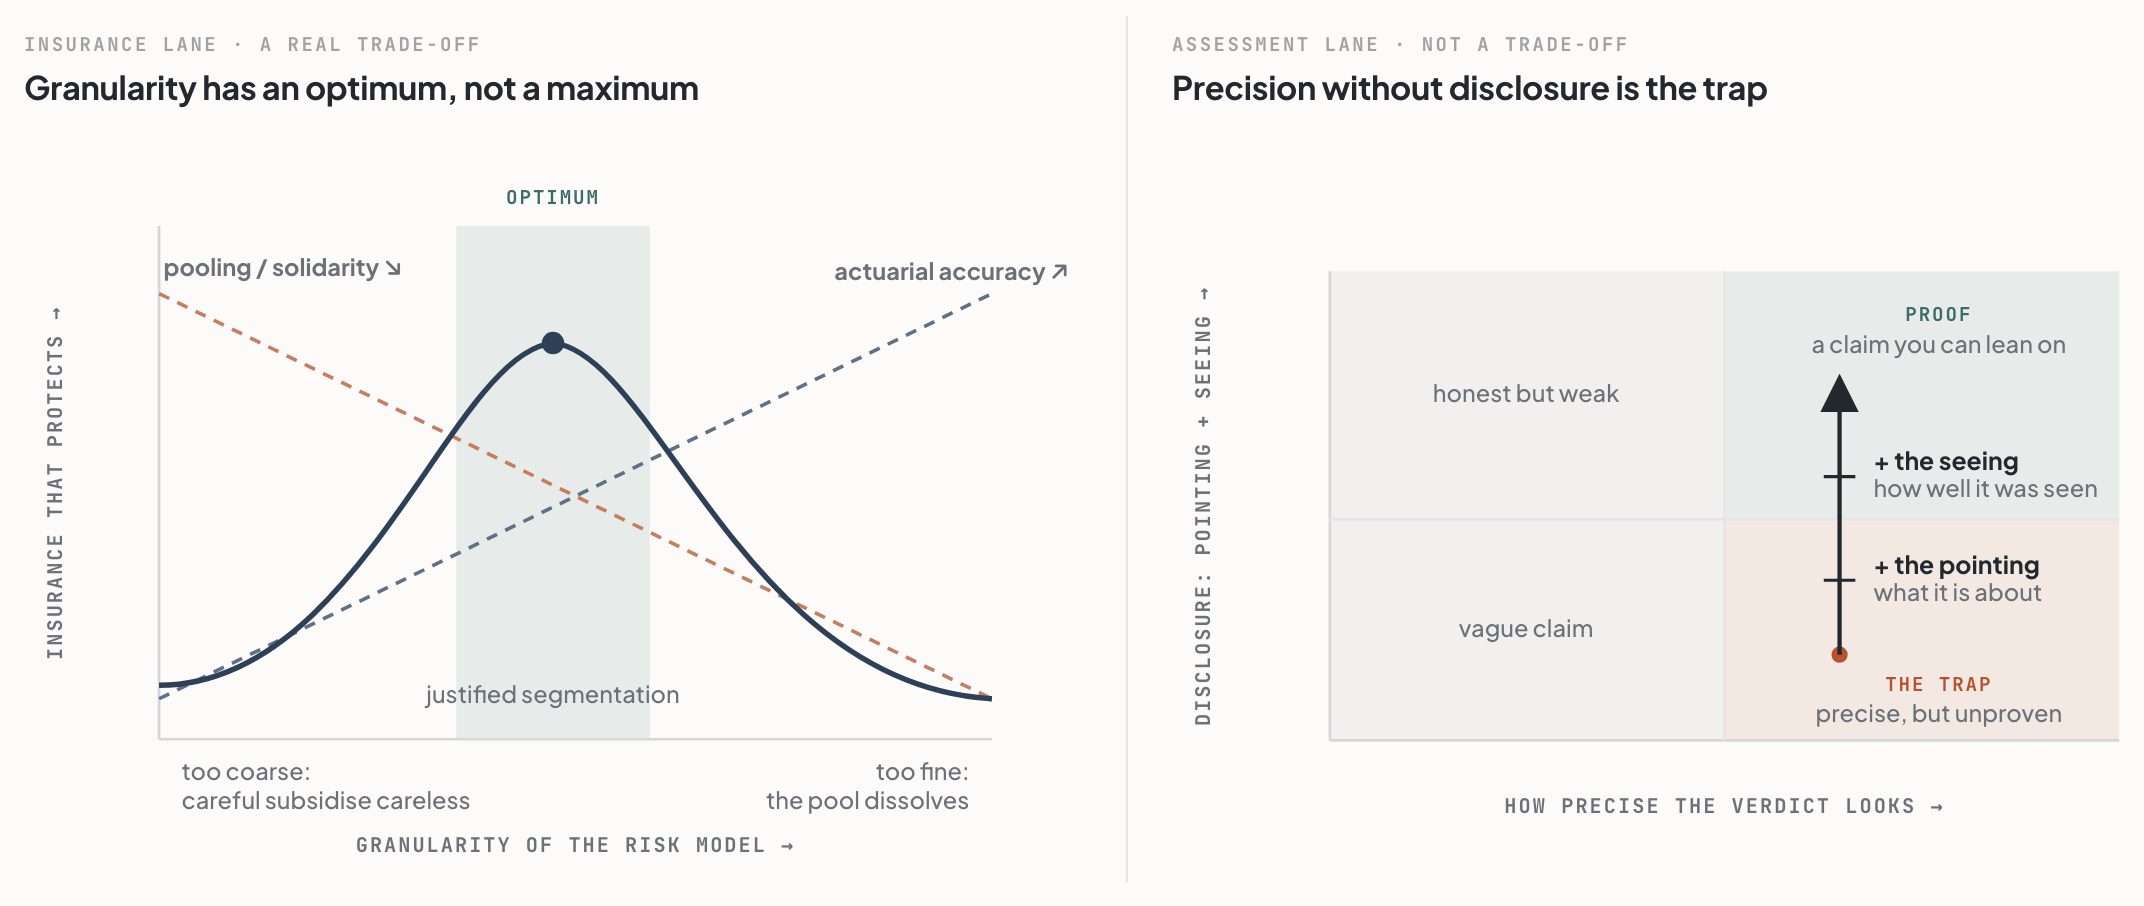
L'argument de la mutualisation. Un modèle de risque qui prédit parfaitement ne tarifie pas l'assurance de manière équitable. Il abolit l'assurance. Le transfert de risque a besoin d'une incertitude résiduelle pour fonctionner et, à mesure que la granularité augmente, le pool se fragmente en un ensemble de prépaiements individuels. La couverture devient alors indisponible précisément pour les personnes que le modèle a identifiées comme en ayant besoin. Un certain degré d'approximation est le mécanisme, pas une de ses failles. Ce qui rend l'argument difficile à rejeter, c'est qu'il repose sur une logique actuarielle, et non éthique.
L'argument de la visibilité. Une conclusion de Fairness ou d'explicabilité vaut ce que valent l'accès, la méthode et la fraîcheur des données qui la sous-tendent. Nous notons les trois : un niveau d'accès, une note de preuve et une note de validité, écrits A2 · E2 · V2.
Et une correction. L'article sur l'orbite présentait trois axes, corps, trajectoire et public, qui permettent de situer une évaluation. La prochaine étape évidente est d'ajouter l'assurance comme quatrième axe. Nous l'avons rédigé ainsi, et c'était une erreur. Un axe indique où vous avez visé. Il ne dit rien sur la qualité de votre vision une fois sur place, et ce sont des informations différentes. L'astronomie d'observation les a séparés il y a des siècles et a des mots pour les deux : le pointage et la visibilité. Nous les empruntons.
Ce qui relie les deux moitiés, c'est le titre. La précision n'est pas une preuve. Dans le domaine de l'assurance, un modèle parfaitement précis n'est pas un modèle équitable ; poussé à l'extrême, ce n'est plus du tout de l'assurance. En matière d'évaluation, un verdict parfaitement assuré n'est pas un verdict prouvé. Les deux confondent un chiffre précis avec la réalité qu'il ne fait qu'esquisser : l'assureur interprète un modèle plus fin comme un prix plus juste, le conseil d'administration interprète « aucune disparité détectée » comme « il n'y a pas de disparité », et à chaque fois, ce qui aurait nuancé le chiffre est laissé de côté. Pour un verdict, les deux éléments omis sont ceux qui donnent leur nom à cet article : le ciblage, ce que nous avons examiné, et la visibilité, la clarté avec laquelle nous pouvions le voir. Une évaluation n'est précise que lorsque les deux sont consignés.
Première partie · Pourquoi un modèle parfait cesse d'assurer qui que ce soit
L'assurance est un pari sur l'ignorance, et cette ignorance doit être partagée.
Un groupe cotise à un pot commun. Personne ne sait à l'avance qui finira avec sa voiture dans une haie, qui découvrira une grosseur, qui descendra pour trouver trente centimètres d'eau de rivière dans son entrée. Le pot commun dédommage celui à qui le malheur arrive. Les primes reflètent la perte attendue du groupe, de sorte que les chanceux finissent par payer pour ceux qui ne le sont pas, et tout le monde achète la même चीज : la libération d'une variance qu'ils n'auraient pas pu absorber seuls. Cette libération est le produit. Pas l'indemnisation, que la plupart des membres ne voient jamais.
Maintenant, améliorons le modèle.
Chaque amélioration divise le pool en compartiments plus fins, et les premières divisions sont manifestement une bonne chose. Séparer un professionnel du transport routier d'une personne ayant trois condamnations pour excès de vitesse est la discrimination exacte sur laquelle le produit est construit. Refuser de le faire ne serait qu'une subvention des prudents aux imprudents, sans aucune justification. Personne de sensé ne s'y oppose.
Mais continuons. La télématique affine la connaissance du conducteur plutôt que de la démographie. Les objets connectés, celle du corps plutôt que de la tranche d'âge. L'imagerie aérienne, celle de votre toit réel plutôt que de votre code postal. Chaque étape est défendable en soi, et voici la partie délicate : personne n'a à décider de la franchir. Un assureur qui refuse de segmenter voit ses bons risques se faire démarcher par un concurrent qui ne refuse pas, se retrouve avec le reste, augmente ses prix pour le couvrir, perd la tranche suivante de bons risques au profit du même concurrent, et découvre un an plus tard que le choix qu'il pensait faire a été fait pour lui aux alentours du deuxième trimestre. La concurrence fait le travail. C'est un effet de cliquet.
Allons jusqu'au bout. Chaque personne se voit proposer une prime égale à sa perte prédite plus une marge. Aucune variance n'est transférée entre les individus, car du point de vue de l'assureur, il n'y a plus de variance à transférer. Ce que vous avez alors est un plan de prépaiement auquel s'ajoutent des frais administratifs, et le qualifier d'assurance est une courtoisie.
Les dommages ne sont pas non plus répartis de manière égale. Ils pèsent sur la personne que le modèle a identifiée comme à haut risque, qui est bien sûr la personne pour qui le produit existait. Elle se voit proposer une prime égale à la perte qu'elle est censée subir. Elle ne peut pas la payer. Cette incapacité est la raison même pour laquelle elle voulait une assurance. Pendant ce temps, l'homme que le modèle apprécie se voit offrir quelque chose de bon marché, dont il aurait très bien pu se passer. Le produit devient le moins disponible là où il est le plus nécessaire, au moment précis où il devient le plus précis.
Vous pouvez observer ce phénomène aujourd'hui, au grand jour, sans aucune avancée en matière de modélisation. La couverture contre les inondations et les incendies de forêt dans les zones exposées de Californie, de Floride et, de plus en plus, du sud de l'Europe, est tarifée au-delà de ce que les résidents peuvent payer, ou a simplement été retirée. Les modèles impliqués sont loin d'être parfaits. Une meilleure prédiction a tout de même entraîné une indisponibilité plutôt que des primes plus justes.
Cette observation sur les marchés n'a rien de nouveau. Rothschild et Stiglitz ont élaboré l'appareil formel de l'asymétrie d'information dans le domaine de l'assurance il y a cinquante ans (1976). Le cas moderne inverse simplement cette asymétrie : l'assureur détient désormais l'avantage informationnel, et le pool s'érode du côté de la souscription plutôt que par l'auto-sélection des demandeurs (Barry et Charpentier, 2020).
Deux choses que cet argument n'est pas, car il est mal interprété dans les deux sens.
Ce n'est pas un plaidoyer pour l'ignorance. La granularité a un optimum, pas un maximum, et la position de cet optimum dépend du secteur d'activité, du caractère essentiel de la couverture et de ce que dit la loi. L'assurance responsabilité civile automobile obligatoire, la couverture catastrophe pour une résidence principale et l'assurance pour animaux de compagnie n'obtiennent pas la même réponse. Ce que l'argument exclut, c'est de traiter la résolution maximale comme l'objectif et le ratio de sinistralité comme le seul témoin. La granularité devient une décision de conception qui doit être justifiée, comme toute autre décision de conception.
Ce n'est pas non plus l'intégralité de l'argument de la Fairness, et la majeure partie du reste relève du droit établi plutôt que de la philosophie ouverte. La tarification basée sur le genre a été interdite dans l'UE par l'arrêt Test-Achats (C-236/09, 2011). L'assurance maladie de base obligatoire en Suisse ne peut pas du tout tarifer en fonction de l'état de santé, et personne en Suisse ne qualifie cela d'injuste, ce qui règle la question de savoir si « actuariellement juste » et « juste » sont synonymes. Le véritable problème technique actuel est la discrimination par proxy : une variable tire-t-elle son pouvoir prédictif d'un lien de causalité avec le risque assuré, ou en reconstituant discrètement un attribut que l'assureur n'est pas autorisé à utiliser (Prince et Schwarcz, 2020) ? L'optimisation des prix en fonction de la propension à comparer les offres est le cas d'école. Elle n'est pas du tout basée sur le risque, elle échoue donc selon les propres normes de l'actuaire, pas les nôtres.
“Un certain degré d'approximation est le mécanisme, pas une de ses failles. Une prédiction parfaite ne vous donne pas une prime équitable. Elle vous donne un compte d'épargne, avec des étapes supplémentaires.”
Première partie · L'argument de la mutualisation
Voilà la première objection traitée, et avant de quitter le sujet de l'assureur, il convient de retenir ce que l'argument a réellement prouvé, car les deux dimensions sur lesquelles repose le reste de cet article en découlent directement.
L'histoire de l'assurance avait deux facettes. La première concernait le périmètre : la finesse avec laquelle vous segmentez le groupe détermine si une prime est juste, ainsi, le même modèle précis est équitable pour un transporteur et ruineux pour la personne qu'il exclut par son prix. Changez ce que le chiffre représente, et sa signification s'inverse. La seconde concernait la mesure : un modèle d'une précision maximale n'est pas un modèle d'une équité maximale, et la précision poussée à l'extrême abolit le produit. La précision n'a jamais été l'objectif ; elle a été confondue avec lui. La précision n'était pas une preuve.
Ces deux facettes sont les deux éléments dont tout chiffre a besoin pour être fiable : son objet et la manière dont il a été obtenu. Pour une prime d'assurance, vous exigeriez les deux sans réfléchir. Pour un verdict sur un système d'IA, dont les enjeux sont plus élevés et la lisibilité bien moindre, le secteur ne fournit que le chiffre. Le reste de cet article est consacré à ces deux informations, nommées et classées : le ciblage, c'est-à-dire l'objet du verdict, et la visibilité, c'est-à-dire la clarté avec laquelle il a pu être observé. La seconde objection est la plus difficile, car à partir de maintenant, il s'agit de notre travail plutôt que de celui de l'assureur.
Un arbitrage, et un autre qui n'en est un qu'en apparence.
Les deux extrêmes échouent de manières différentes, et il est utile de nommer cette différence avant de s'appuyer dessus. Celui de l'assureur est un véritable compromis : la précision et le pool ne peuvent être maximisés simultanément, de sorte que la Fairness se situe à un optimum au milieu plutôt qu'à l'extrême. Il s'agit d'une mesure, pas d'une affirmation. La part des sinistres d'une population que l'assurance couvre réellement est la plus élevée avec une classification modérée des risques et diminue à mesure que les prix approchent une différenciation parfaite des risques (Thomas, 2017 ; Crocker et Snow, 1986), ce qui explique formellement pourquoi « actuariellement équitable » n'a jamais été synonyme d'« équitable » (Landes, 2015).
L'extrême de l'évaluation ressemble à un compromis, mais n'en est pas un. Un verdict précis et un verdict prouvé ne sont pas les deux extrémités d'un curseur entre lesquelles on navigue ; les deux sont souhaitables, et la précision seule ne suffit tout simplement pas. Un chiffre ne mérite la confiance que s'il indique également ce qu'il représente et avec quelle fiabilité il a été observé. Le publier sans contexte n'est donc pas un équilibre trouvé, mais une information non divulguée. Deux disciplines plus anciennes sont catégoriques à ce sujet. La métrologie considère une mesure sans incertitude déclarée comme un résultat totalement inutilisable, et maintient la fidélité et la justesse comme des propriétés distinctes (le GUM et la norme ISO 5725) ; l'étude du jugement qualifie le chiffre brut et assuré de sur-précision, la manière la plus tenace d'être certain de choses que nous n'avons pas méritées (Moore et Healy, 2008) ; et les statistiques médicales insistent sur le fait qu'un résultat nul n'équivaut pas à une absence de découverte tant qu'il n'indique pas la plus petite taille d'effet qu'il aurait pu détecter (Altman et Bland, 1995).
Deuxième partie · Le ciblage : l'objet d'une évaluation
Quelqu'un vous remet un document. Un système d'IA a été évalué, y est-il écrit, et jugé digne de confiance.
Avant de vous demander si c'est vrai, demandez-vous sur quoi porte cette affirmation. La plupart des affirmations de confiance en circulation ne survivent pas à cette question, et généralement pas parce que le travail sous-jacent était mauvais. Le travail était correct. Il n'a jamais été situé.
Trois questions permettent de le situer. Nous les appelons des axes car ils tournent indépendamment : bougez-en un et les deux autres restent immobiles. Une véritable évaluation est un réglage sur chacun d'eux, souvent une petite plage plutôt qu'un seul cran.
| Cadran | La question à laquelle il répond | Ses réglages |
|---|---|---|
| Corps | Quel corps, quelle offre ? | Confiance Numérique · Fairness et Explicabilité de l'IA · Identité Auto-Souveraine (prévu) |
| Voie | Quel type de système d'IA ? | Prédictif · Génératif / LLM · Agentique (prévu) · Multi-agent (prévu) |
| Audience | À qui s'adresse le rapport ? | Ceux qui le construisent · le gouvernent · y sont soumis · l'examinent en externe |
Une ligne dans un tableau ne leur rend pas justice, car chacun modifie la question même que pose le mot « équitable ».
Corps
Tout déploiement se divise en trois acteurs, sans rien omettre. Le modèle qui décide. La personne concernée par la décision. L'organisation qui a mis le système au monde et doit en répondre. La confiance n'est aucun d'entre eux ; c'est la forme qu'ils dessinent lorsqu'ils sont en équilibre, ce qui est l'argument de l'article sur l'orbite et la raison pour laquelle aucune offre unique ne peut vous apporter la confiance à elle seule.
Pour une évaluation, la conséquence est sans appel. Un bilan de santé irréprochable pour le modèle ne vous dit rien sur la gouvernance, et un programme de gouvernance impeccable ne vous dit rien sur le caractère discriminatoire du modèle. Il ne s'agit pas de versions plus ou moins fortes d'une seule et même mesure. Une grande banque peut appliquer un cadre de gestion du risque modèle de manuel à un modèle qui échoue largement au test d'égalité des chances. Quatre personnes dans une pièce peuvent exploiter un modèle manifestement équitable sans aucune structure de surveillance. Les deux cas se produisent. Les deux sont présentés comme de l'IA digne de confiance.
Voie
Ce cadran a le plus de poids et attire le moins l'attention. Ce qui change avec le type de système, c'est la nature du problème de confiance, pas sa difficulté.
Les modèles prédictifs produisent un score ou une classe, et les questions de Fairness sont bien posées. Le score signifie-t-il la même chose pour tous les groupes ? Les taux d'erreur sont-ils comparables ? La sélection est-elle proportionnée ? Vous ne pouvez pas les avoir tous en même temps lorsque les taux de base diffèrent, ce qui est un théorème plutôt qu'un bug (Chouldechova, 2017 ; Kleinberg, Mullainathan and Raghavan, 2017). Le travail de l'évaluateur consiste donc à découvrir quel compromis a été fait, si quelqu'un a remarqué qu'il le faisait, et s'ils ont justifié leur choix par écrit.
Les systèmes génératifs produisent du texte, et souvent, il n'y a pas d'étiquette de référence pour juger de l'exactitude. La Fairness doit être construite plutôt que mesurée. On fait varier un nom, un pronom, un dialecte, et on compare le résultat. On cadre la tâche ouverte comme une décision évaluable afin d'avoir quelque chose à compter. Des modes de défaillance apparaissent qui n'ont pas d'analogue prédictif, la fabrication et la provenance étant les principaux (Ji et al., 2023). Et le sujet se dérobe : la température introduit de la variance, et le point de terminaison peut être remplacé sous un nom stable sans que personne ne vous en informe.
Les systèmes agentifs agissent. Désormais, la question n'est plus ce qui a été produit, mais ce qui a été fait, sous l'autorité de qui, et qui répond lorsqu'une chaîne d'appels d'outils tourne mal au nom de quelqu'un. La disparité peut se cacher dans la sélection des outils, dans la récupération d'informations, dans la manière dont le travail est délégué, ou n'être visible à aucune étape individuelle tout en étant évidente sur l'ensemble de la trajectoire.
Les systèmes multi-agents ajoutent des défaillances qui n'appartiennent à aucun agent individuel. Amplification. Convergence. Dérive au fil des tours. Auditez chaque agent, validez chaque agent, et passez complètement à côté du phénomène.
C'est pourquoi les benchmarks se transposent si mal. Un score de Fairness ajusté sur un classifieur prédictif ne dit presque rien sur un workflow multi-agents, et le citer comme s'il était pertinent est l'une des mises en scène de la confiance les plus courantes dans le domaine.
Audience
Le plus subtil, et le plus sujet aux abus, il est donc soumis à une règle stricte. L'audience change la formulation, jamais les chiffres.
Un conseil d'administration veut la décision et l'exposition au risque. Un ingénieur veut la métrique, l'intervalle et suffisamment de détails pour la reproduire. Une personne concernée par une décision veut savoir ce qui lui est arrivé et ce qu'elle peut faire, à la deuxième personne, sans aucun jargon. Un évaluateur externe veut le protocole et les décomptes bruts pour pouvoir le refaire et être en désaccord avec nous. Mêmes preuves, quatre documents.
La règle existe parce que c'est sur ce cadran qu'un résultat peu probant est blanchi. Si le rapport technique indique qu'une disparité est significative et substantielle, et que, le temps que la même preuve soit passée par un résumé, une présentation et un paragraphe rédigé par un communicant à qui l'on a demandé de rester positif, le conseil d'administration lit que la situation globale est largement rassurante, alors personne tout au long de cette chaîne n'a fait un choix de communication. Quelqu'un a déformé un résultat. Notre réponse est mécanique plutôt que culturelle : chaque vue d'audience est générée à partir d'un dossier d'évaluation unique et partagé, et les chiffres sont hérités, non réinterprétés.
Un assureur, trois évaluations, trois réponses vraies
Prenons un assureur européen qui utilise un modèle génératif pour rédiger la correspondance relative aux sinistres, reposant sur un modèle prédictif qui note les sinistres pour l'examen des fraudes.
| Réglages des cadrans | Verdict honnête |
|---|---|
| Modèle · Prédictif · Évaluateur externe | Le score de fraude n'est pas calibré de la même manière pour deux groupes linguistiques. L'écart est significatif et substantiel. |
| Modèle · Génératif / LLM · Ceux qui le construisent | Le ton du modèle de rédaction change de manière mesurable en fonction du nom de famille du demandeur. Aucun effet sur la décision elle-même. |
| Organisation · Prédictif · Ceux qui le gouvernent | La gouvernance est saine : décisions de compromis documentées, une voie de recours fonctionnelle, nouveaux tests trimestriels. |
Les trois sont valables simultanément. N'importe laquelle d'entre elles, présentée comme « nous avons évalué le système d'IA », est un slogan. Ne publiez que la troisième et vous aurez décrit une entreprise exerçant une excellente surveillance sur un modèle mal calibré, et l'aurez qualifiée de digne de confiance.
Une évaluation est donc un emplacement : un point dans l'espace du corps, du parcours et de l'audience, qui s'étend en une région à mesure que le périmètre s'élargit. Voilà l'intégralité de la première dimension, le ciblage.
Ce n'est pas seulement une métaphore. Il s'agit de la commande réelle sur la plateforme validant.ai. Lorsque vous positionnez une évaluation, les trois cadrans représentent trois axes étiquetés ; vous sélectionnez une ou plusieurs valeurs sur chacun d'eux, et un cube déplaçable indique la région occupée par l'évaluation. C'est ainsi qu'un périmètre est défini, établi et visualisé en pratique, et non pas seulement la manière dont nous le décrivons sur le papier.
Voici maintenant ce que les trois cadrans ne peuvent pas faire. Chaque verdict de ce tableau pourrait provenir d'une étude contrôlée et pré-enregistrée sur une version de modèle figée, ou de trois après-midis passés à interroger un point de terminaison dont les poids ont été remplacés depuis. Les réglages des cadrans sont identiques dans les deux cas.
Troisième partie · La visibilité : la clarté de l'observation
C'était la première dimension : le ciblage, là où nous avons regardé. Elle est nécessaire, mais elle n'est pas suffisante, car elle ne dit rien sur la clarté de notre vision une fois sur place. C'est la deuxième dimension, la visibilité, et c'est celle que le secteur omet. La solution de facilité serait de l'ajouter comme un quatrième cadran pour la profondeur. Nous l'avions rédigé ainsi, et c'était une erreur, et la raison mérite un paragraphe, car elle constitue l'ensemble de la conception.
Un cadran localise. Qualifier l'assurance de quatrième cadran reviendrait à dire qu'un résultat superficiel est un type de résultat différent d'un résultat approfondi, se situant ailleurs dans le même espace. Il ne se situe pas ailleurs. C'est le même résultat, mais tenu avec moins de certitude. Où nous avons visé et avec quelle clarté nous pouvions voir sont les réponses à deux questions différentes, et leur faire partager un système de coordonnées est la façon dont un résultat étroit, superficiel et obsolète en vient à porter les mêmes habits qu'un résultat approfondi.
L'astronomie d'observation a réglé ce problème il y a longtemps, et il est intéressant de voir comment.
Un astronome enregistre deux choses et ne les mélange jamais. D'abord le pointage : ascension droite et déclinaison, là où l'instrument était dirigé. Ensuite la vision (seeing) : quel télescope, quelle ouverture, quel filtre, quelle durée d'exposition, quelle était la stabilité de l'air, et l'époque, car le ciel bouge et une position sans date n'est pas une position. Le pointage indique où elle a regardé. La vision indique ce qui pouvait être résolu à partir de là, et cela est consigné dans le journal sous la forme d'un nombre, en secondes d'arc, chaque nuit, sans que personne ne le considère comme un aveu de faiblesse.
Strictement parlant, le terme « seeing » (vision) se réfère uniquement à la stabilité atmosphérique. Nous l'utilisons comme le font les observateurs, comme un raccourci pour tout ce qui, ensemble, a défini la limite de ce qu'une nuit donnée pouvait révéler.
Nous reprenons les deux termes. Ils permettent de distinguer les deux types d'informations, sans emprunter le mot « objet », qui en astronomie signifie déjà un corps, et nous en avons déjà trois.
| Information | La question à laquelle il répond | Présenté comme |
|---|---|---|
| Le pointage | Où avons-nous regardé ? | Corps · Voie · Audience |
| L'observation | Avec quelle précision pouvions-nous le voir ? | Accès · Preuve · Validité |
Le pointage peut être impeccable alors que l'observation est déplorable. Cette combinaison décrit une grande partie de la littérature publiée sur la confiance.
Il y a une autre convention qui mérite d'être empruntée, et elle est plus efficace que toutes les autres réunies. Une non-détection n'est jamais publiée sans une magnitude limite. « Nous ne l'avons pas vu » n'est pas un résultat que quiconque accepterait. « Nous aurions détecté tout ce qui est plus brillant qu'une magnitude de 21.3, et n'avons rien vu » en est un. La première informe discrètement le lecteur qu'il n'y a rien. La seconde énonce ce qui aurait pu passer inaperçu. Deux siècles de précédent pour notre troisième règle.
L'observation a trois composantes. Elles sont indépendantes, et une note unique masquerait les compromis entre elles : cinquante mille paires contrefactuelles contrôlées à distance valent mieux que quarante échantillons avec les poids en main, et aucune moyenne ne peut le refléter.
Ouverture · le niveau d'accès
Ce que l'évaluateur pouvait observer. Le plus souvent, ce n'est pas notre choix.
| Niveau | Nom | Ce que détient l'évaluateur | Affirmation la plus élevée qu'il permet |
|---|---|---|---|
| A0 | Attesté | Documentation du fournisseur, fiche de modèle, évaluations publiées. Pas de sondage. | Les propres affirmations du sujet, enregistrées et vérifiées pour leur cohérence interne. |
| A1 | Comportemental | Accès par requête. Sortie terminal uniquement : texte, étiquette, décision. | Disparité dans les résultats observés, présente ou absente à une sensibilité déclarée. |
| A2 | Avec scores | A1 plus scores par sortie : log-probabilités, probabilités de classe, alternatives classées, confiance. | Calibration et comportement au seuil par groupe. Disparité de classement et de marge. |
| A3 | Interne | Poids, activations, gradients. La capacité d'intervenir sur le calcul. | Quelles structures internes sont porteuses de la disparité. Attribution mécaniste. |
| A4 | Provenance | A3 plus lignée du corpus d'entraînement, historique de l'ajustement fin et des données de préférence, historique des évaluations. | D'où provient la disparité dans le cycle de vie. |
La réalité commerciale se situe principalement aux niveaux A1 et A2. Un déployeur évaluant un modèle frontière tiers ne peut pas aller plus loin, et ne le pourra contractuellement jamais. Ce n'est pas une raison pour abandonner la mission, et c'est là que les deux capacités se distinguent nettement.
La mesure de la Fairness est une discipline d'entrée-sortie et fonctionne bien au niveau A1. Les métriques de groupe proviennent des prédictions, des étiquettes et de l'appartenance au groupe ; les poids n'y entrent jamais en jeu. Les modèles frontières fermés sont véritablement évaluables en matière de Fairness. Les contraintes sont d'ordre pratique : coût des requêtes pour les tailles d'échantillon qu'exige la puissance statistique, non-déterminisme sans contrôle de la graine aléatoire, filtres de sécurité qui absorbent les sondes, conditions du fournisseur qui interdisent parfois les tests adversariaux, et mises à jour silencieuses des points de terminaison qui rendent discrètement le travail obsolète.
L'explicabilité ne se transpose pas aussi bien. Au niveau A1, on trouve les substituts de perturbation et l'auto-évaluation, et les raisons déclarées d'un modèle constituent des preuves concernant son résultat plutôt que son calcul (Turpin et al., 2023). Au niveau A2, l'analyse de sensibilité et l'attribution contrastive deviennent véritablement possibles. Les affirmations sur les mécanismes ne commencent qu'au niveau A3. Un rapport d'explicabilité qui n'indique pas son niveau formule une affirmation pour laquelle il ne disposait peut-être d'aucun instrument.
Méthode · le niveau de preuve
La force de l'inférence, compte tenu de ce qui a été réellement exécuté.
| Niveau | Nom | Norme respectée |
|---|---|---|
| E0 | Affirmé | Repose sur une déclaration du sujet ou sur une auto-évaluation du modèle. Aucune mesure indépendante. |
| E1 | Observationnel | Mesuré sur des données trouvées ou de convenance. Facteurs de confusion non contrôlés. Uniquement descriptif. |
| E2 | Contrôlé | Protocole pré-enregistré, échantillon de taille suffisante, perturbation contrefactuelle contrôlée, estimations par intervalle, correction pour tests multiples. |
| E3 | Interventionnel | Le mécanisme est manipulé plutôt qu'observé : assignation aléatoire de l'attribut modifié, ablation ou intervention au niveau de l'activation avec analyse de médiation. |
Les résultats d'explicabilité comportent également un modificateur de fidélité, car les méthodes d'attribution ne sont pas interchangeables en termes de poids probant : F0 auto-évaluation, F1 substitut de perturbation (Ribeiro et al., 2016 ; Lundberg and Lee, 2017), F2 gradient ou localement exact, F3 intervention causale.
Époque · le niveau de validité
Quand c'était vrai, et si ça l'est toujours.
| Niveau | Nom | Norme respectée |
|---|---|---|
| V0 | Non-ancré | Aucun identifiant de version, aucun enregistrement de configuration, aucune expiration. |
| V1 | Ancré | Instantané ou identifiant de version, configuration et horodatage enregistrés. Un point unique dans le temps, avec une expiration déclarée. |
| V2 | Ré-échantillonné | V1 plus des tests répétés et planifiés à un intervalle déclaré, avec détection des changements entre les exécutions. |
| V3 | Continu | Surveillance en production avec détection de dérive et seuils d'alerte. L'affirmation est actuelle plutôt qu'historique. |
Le niveau V0 est omniprésent et doit être considéré comme éliminatoire. Les points d'accès hébergés sont mis à jour derrière des noms stables, la température et le prompt système modifient le sujet testé, une couche de sécurité peut être réécrite un mardi après-midi sans aucune annonce, et l'effet cumulé est qu'un résultat enregistré en mars concernant un modèle accessible à une adresse donnée peut, en juin, ne plus rien décrire qui existe encore à cette adresse. C'est aussi pourquoi l'assurance continue est la forme honnête du produit plutôt qu'une vente additionnelle. L'orbite n'étant pas stable, la mesure ne peut l'être non plus.
Le vocabulaire utilisé ici est emprunté à dessein. Les auditeurs distinguent depuis des années l'assurance limitée de l'assurance raisonnable (ISAE 3000 Revised), et les cadres d'identité ont classé les niveaux d'assurance bien avant que quiconque n'audite des modèles (NIST SP 800-63-3 ; eIDAS faible, substantiel, élevé). Un concept assemblé à partir des deux est plus difficile à rejeter comme une simple invention de fournisseur.
Quatrième partie · Cinq règles pour le rendre porteur
Un système de notation qui ne fait que flatter l'évaluateur n'est que de la décoration. Ces cinq règles garantissent son honnêteté, et chacune a un coût.
R1 · Maillon faible
La classe de l'affirmation principale est plafonnée par le composant le plus faible. min(A, E, V) correspond à Indicatif, Limité ou Raisonnable, en utilisant ces termes comme le font les auditeurs. Un seul composant faible plafonne le verdict. Pas de moyenne, car c'est en faisant la moyenne qu'une méthode approfondie sur un instantané obsolète se transforme en une affirmation forte.
R2 · Plafond déclaré
Une phrase par constatation, indiquant ce que cette configuration n'aurait pas pu détecter. Non pas ce qui n'a pas été trouvé, mais ce qui était indétectable par construction. Au niveau A1, cette phrase indique, en substance, qu'aucune affirmation n'est faite concernant le mécanisme interne produisant ces résultats.
R3 · Ampleur limite pour chaque résultat nul
L'absence de constatation n'est pas la constatation d'une absence. Chaque non-constatation est assortie d'un effet détectable minimum avec sa puissance, son alpha et la taille de son échantillon :
“Cette évaluation aurait détecté une disparité de 3.0 points de pourcentage ou plus dans le taux de sélection avec une puissance de 80 %, α = 0.05, sur 12 400 sondes appariées.”
R3 · Un résultat nul avec son ampleur limite
Cela transforme une affirmation marketing en une affirmation quantifiée. C'est aussi la première phrase que toute personne souhaitant un résultat sans équivoque essaiera de supprimer, ce qui constitue un bon argument pour la rendre structurelle plutôt qu'éditoriale.
R4 · Séparation
Le profil d'assurance est une métadonnée sur notre travail et n'entre jamais dans le résultat de Fairness du sujet. Un fournisseur ne doit pas obtenir un meilleur score de Fairness pour avoir accordé un accès plus approfondi, sinon la mesure est contaminée par ses propres conditions d'observation. L'ouverture est récompensée par une note d'auditabilité distincte, ce qui est sa juste place. Deux sujets avec des constatations identiques aux niveaux A1 et A3 ne sont pas également dignes de confiance. Cette différence est réelle. Ce n'est simplement pas une différence de Fairness.
R5 · Lisible par machine et vérifiable
Le profil est fourni sous forme de métadonnées structurées pour chaque constatation, et non sous forme de prose dans un pied de page, car il doit survivre à un copier-coller dans le système de conformité d'un tiers. La métaphore reste en dehors du schéma : le pointage et la vision sont notre façon de l'expliquer ; la portée et l'assurance sont notre façon de le sérialiser. Un nom de champ ne devrait pas nécessiter un article pour être décodé.
{
  "finding_id": "f_8c41e0",
  "scope": {
    "body": "model",
    "pathway": "generative_llm",
    "audience": "external_reviewer"
  },
  "assurance": {
    "access": "A1",
    "evidence": "E2",
    "faithfulness": null,
    "validity": "V2",
    "claim_class": "limited"
  },
  "subject": {
    "identifier": "vendor/model@2026-07-14",
    "configuration_hash": "sha256:1f9a",
    "assessed_at": "2026-07-22T09:14:00Z",
    "expires_at": "2026-10-20T00:00:00Z"
  },
  "result": "no_disparity_detected",
  "detection_sensitivity": {
    "metric": "selection_rate_difference",
    "minimum_detectable_effect": 0.030,
    "power": 0.80,
    "alpha": 0.05,
    "n_probes": 12400
  },
  "declared_ceiling": "Behavioural access only. No claim is made about the internal mechanism producing these outputs, and no mechanistic attribution was possible at this tier."
}Le format lisible par machine est nécessaire, mais pas suffisant. Un objet JSON que n'importe qui peut modifier dans un éditeur de texte ne prouve rien ; collé dans un système de conformité, il ne s'agit toujours que d'une affirmation habillée d'un schéma. Le profil ne circule donc pas sous forme de JSON brut. Il circule sous la forme d'un justificatif vérifiable : signé par l'émetteur, inviolable et vérifiable par un tiers sans jamais avoir à nous contacter. Nous l'émettons sous la forme d'un SD-JWT VC, un justificatif vérifiable à divulgation sélective signé avec une clé ES256 que nous publions sur did:web:validant.ai et que nous révoquons via une IETF Token Status List, de sorte que le verdict, toujours divulgué, peut être vérifié par n'importe qui, tandis que les détails sensibles restent scellés jusqu'à ce que le détenteur choisisse de les révéler. Aucun de ces formats n'est un format propriétaire. Ce sont les briques de base de l'e-ID officielle et de l'infrastructure de confiance de la Suisse, swiyu, et du portefeuille d'identité numérique de l'UE, choisis pour qu'un sceau s'intègre dans un écosystème de confiance national plutôt que de demander à quiconque de nous croire sur parole. « Lisible par machine » signifie qu'un ordinateur peut analyser le profil ; « vérifiable » signifie qu'un ordinateur peut prouver qu'il est bien de nous et qu'il n'a pas été modifié. Une conclusion fiable d'une organisation à l'autre requiert les deux.
Cinquième partie · Comment lire l'un de ces rapports
Tout cela ne vaut rien si un lecteur ne peut l'exploiter en dix secondes. Voici donc à nouveau le rapport de la quatrième partie, abordé comme le ferait un lecteur sceptique : de bas en haut, la sensibilité d'abord et la portée en dernier.
| La lecture, dans l'ordre | Ce que dit le rapport | Ce qu'il vous permet d'affirmer, et ce qu'il invalide |
|---|---|---|
| 1 · Résultat, puis sa sensibilité | aucune disparité détectée, jusqu'à 3,0 pp | Rien n'a été trouvé au-dessus de trois points. Un écart de deux points pourrait toujours exister, sans être détecté. La question de savoir si deux points sont importants relève de votre décision commerciale, et non une question que nos statistiques peuvent éluder. |
| 2 · Époque | V2 · figée le 14 juil. · expire le 20 oct. | Valable pour une version figée, et uniquement jusqu'à son expiration. Lisez-le en novembre et ce sera de l'histoire ancienne. |
| 3 · Périmètre | A1 · comportemental | Ce que le système fait, jamais pourquoi. Citez-le comme preuve d'un mécanisme interne sain et vous aurez outrepassé l'instrument. |
| 4 · Classe d'assertion | Limitée, plafonnée par le périmètre A1 | Le maillon le plus faible fixe le plafond. Emprunté aux pratiques d'audit, le terme signifie que le résultat étaye une conclusion sans être pour autant concluant. |
| 5 · Portée | Modèle · Génératif · Évaluateur externe | Ce modèle uniquement. Cela ne dit rien sur la gouvernance du déployeur, ni sur le modèle prédictif sous-jacent. |
Cinq vérifications, et ce qui en ressort est une affirmation sur laquelle vous pouvez vous appuyer à un degré déclaré, sur un objet déclaré, jusqu'à une date déclarée.
Ce que les cinq vérifications détruisent, c'est la phrase que tout le monde veut réellement, à savoir que l'IA est équitable. Cette phrase n'est disponible à aucun niveau d'assurance. Quiconque la propose vend l'omission.
Sixième partie · D'un relevé à un enregistrement
Une mesure est un instant. Vous avez pointé quelque part, vous avez observé aussi bien que votre accès, vos preuves et votre validité le permettaient, et vous avez noté un résultat. Mais il est facile de revenir sur un instant. L'échec silencieux de la plupart des garanties en matière d'IA n'est pas que le premier relevé soit erroné. C'est que la cible se déplace par la suite, et que personne ne le remarque. La métrique qui semblait mauvaise en mars est discrètement remplacée par une autre plus favorable en avril. Le périmètre se rétrécit. La population qui présentait l'écart n'est plus dans le périmètre. Le chiffre s'améliore, mais rien de réel n'a changé. C'est ainsi que la précision devient une mise en scène : non pas en mentant sur le relevé, mais en déplaçant l'objet du relevé.
Le relevé doit donc devenir un enregistrement, et trois conditions doivent être réunies.
L'objectif doit rester fixe. Dès que vous effectuez un premier relevé honnête, deux des coordonnées de pointage ne sont plus modifiables : l'entité que vous évaluez et la trajectoire de préjudice que vous surveillez. Ensemble, elles constituent l'objectif, et un objectif que l'on peut réécrire n'est pas un objectif, c'est une humeur. À partir de ce moment, l'objectif est gelé. Vous pouvez toujours évaluer autre chose, mais il s'agira d'un nouvel objectif avec son propre enregistrement, et non d'une modification discrète de celui-ci. La troisième coordonnée, l'audience, reste libre, car l'audience ne modifie jamais les chiffres. Le même résultat gelé est simplement communiqué à un développeur, un régulateur ou la personne concernée, dans le registre adapté à chacun. Votre interlocuteur est une lentille, pas un levier.
La garantie se mérite, elle ne se déclare pas. Une fois l'objectif fixé, les notes d'observation deviennent le lieu honnête où le progrès peut se produire. Une première itération peut être Indicative : vous aviez des données mais pas le modèle, un seul échantillon, pas de surveillance en direct. Ce n'est pas un échec à cacher, c'est une ligne de départ à enregistrer. L'itération suivante mérite plus : vous obtenez le modèle, donc l'accès augmente ; vous exécutez des intervalles de confiance appropriés avec correction, donc les preuves augmentent ; vous activez la surveillance continue, donc la validité augmente. Chaque itération scelle sa propre note et ne peut la perdre par la suite. Ce que le lecteur observe, à travers une pile d'itérations scellées, n'est pas un chiffre qui fluctue, mais un plancher qui s'élève sous un objectif fixe. C'est la différence entre obtenir un bon score une fois et devenir réellement meilleur pour observer la même chose. Seule la seconde option inspire la confiance.
La règle principale pour chaque itération reste la règle stricte de la quatrième partie : la garantie est le minimum de l'accès, des preuves et de la validité, jamais la moyenne. Un test statistique brillant sur des données que vous n'avez pu que survoler reste un survol. Vous ne pouvez pas compenser un manque d'accès par l'ingéniosité, et le sceau refuse de vous laisser prétendre le contraire.
| Coordonnée | Règle | Pourquoi |
|---|---|---|
| Entité et trajectoire, l'objectif | Une valeur pour chacune, gelée à la clôture de la première itération | Un objectif que l'on peut réécrire n'est pas un objectif. Si la cible peut bouger, toute amélioration est vaine. |
| Audience | Toutes, toujours | L'audience est une lentille, pas un levier. Les mêmes chiffres gelés sont communiqués à un développeur, un régulateur ou la personne concernée. L'interlocuteur ne change jamais la vérité des faits. |
| Observation : accès, preuves, validité | Notée par itération, scellée, peut augmenter mais jamais régresser | Une première passe peut être Indicative. L'obtention du modèle, de vrais intervalles de confiance et d'une surveillance en direct augmentent chacun une note, de sorte qu'un plancher s'élève sous un objectif fixe. |
D'un sceau à un programme
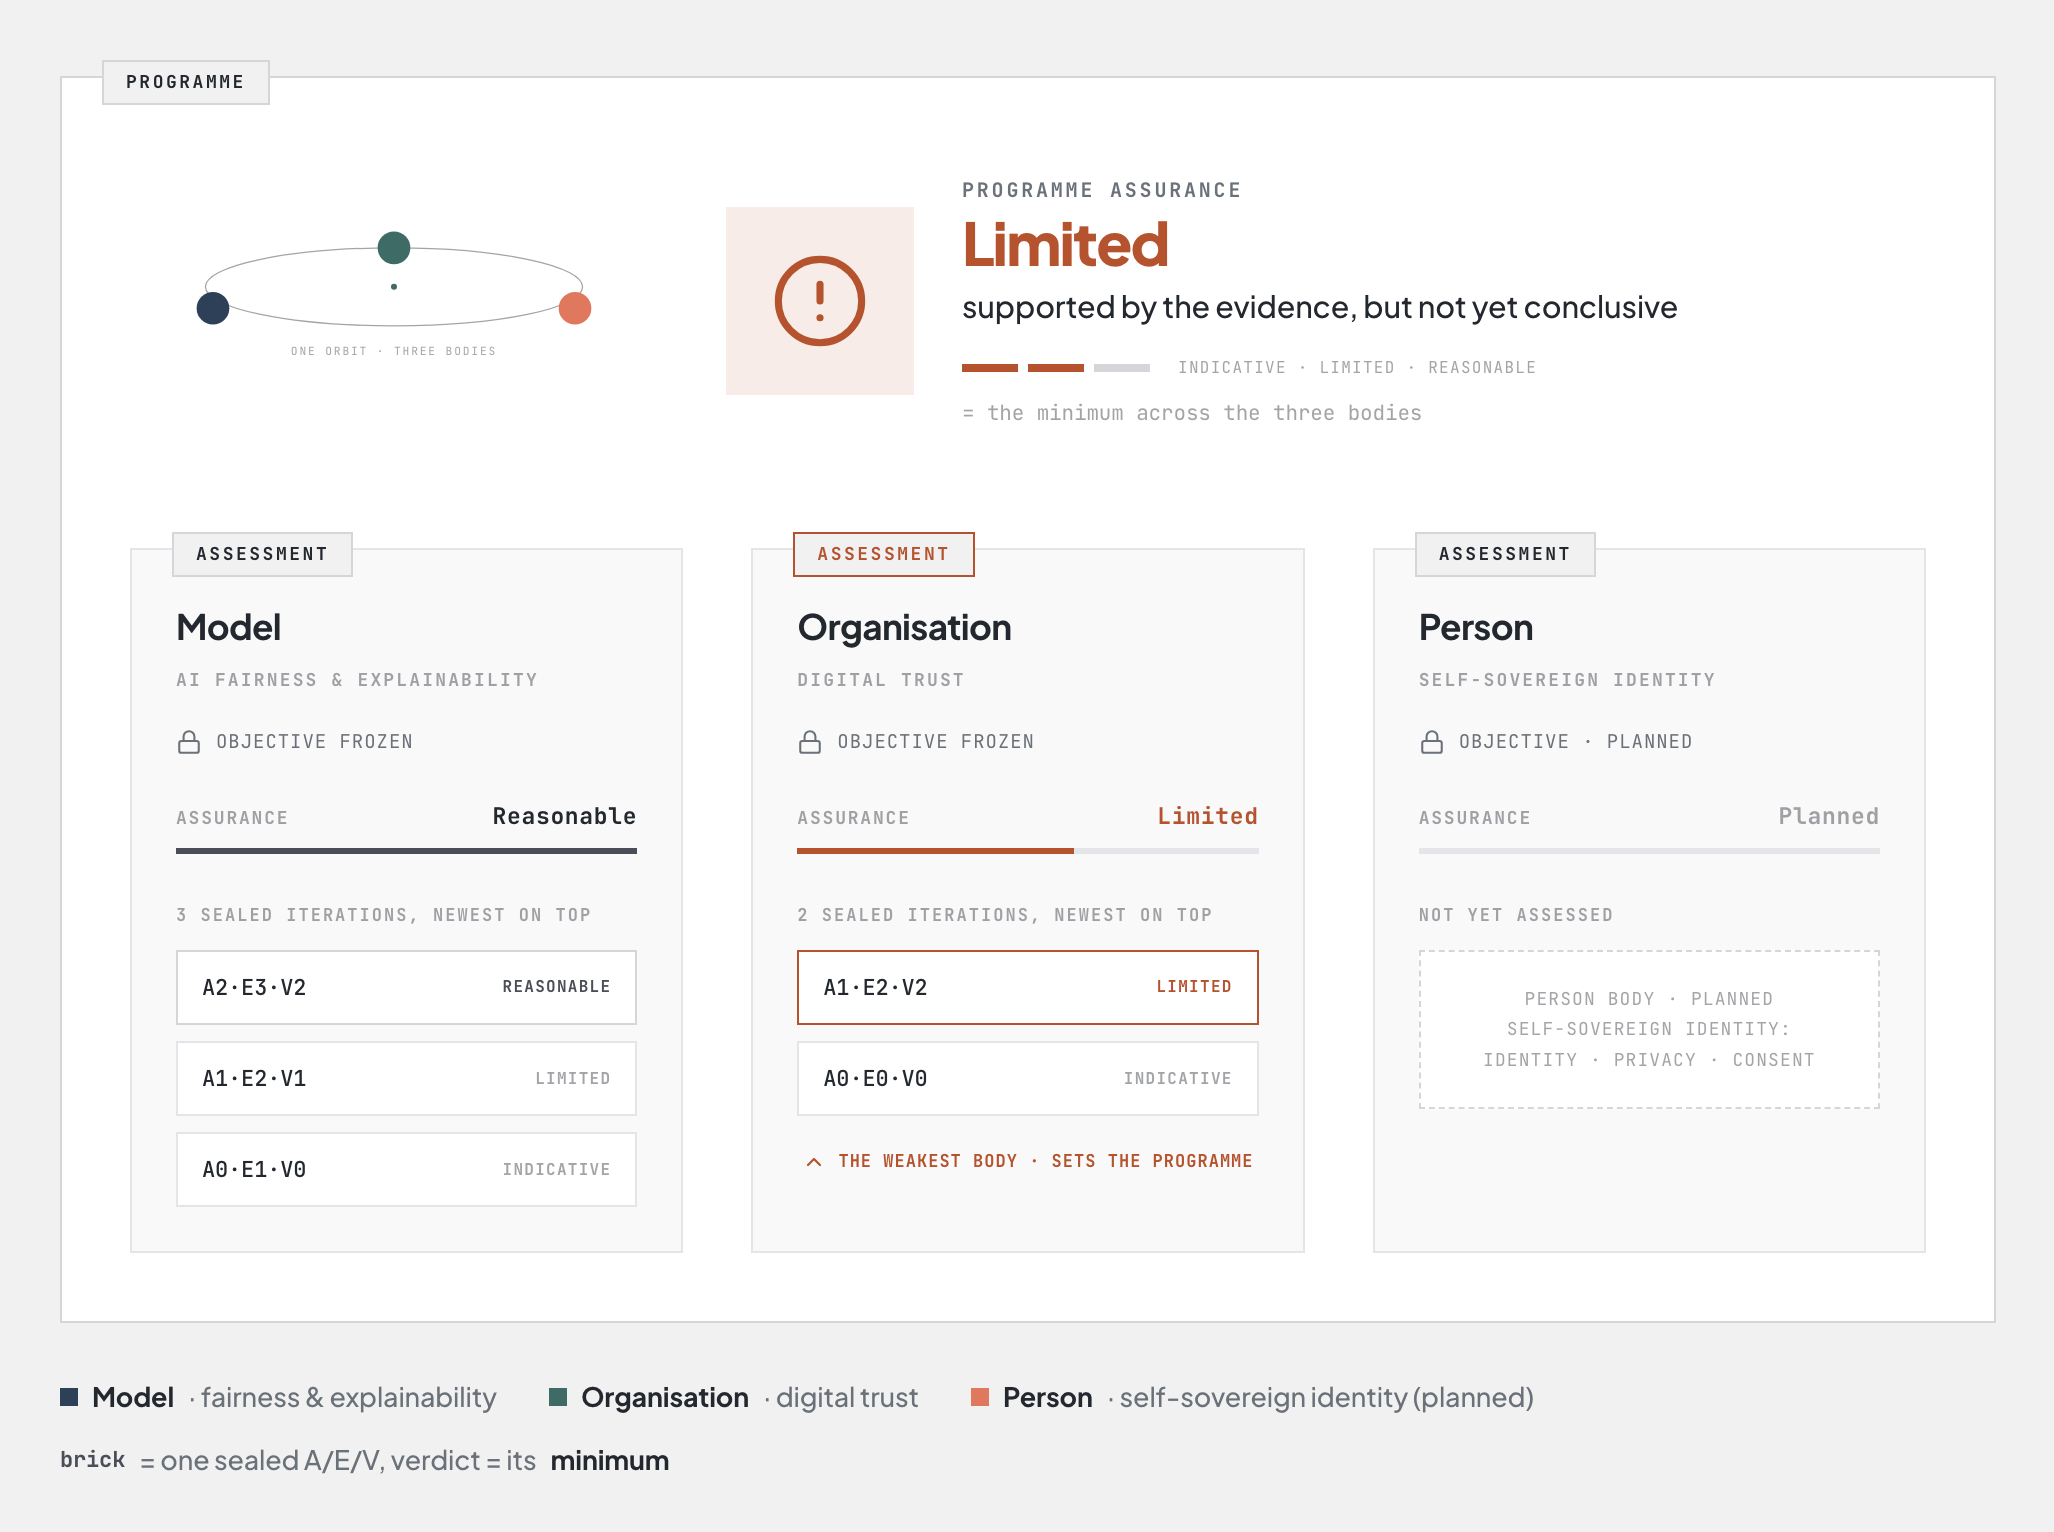
Un sceau couvre une entité. Mais un déploiement réel n'est jamais une seule entité. Lorsqu'une entreprise met un système d'IA sur le marché, trois entités sont en jeu simultanément : le modèle qui prend la décision, la personne sur qui la décision s'applique, et l'organisation qui l'a conçu et le gouverne. La confiance dans le système ne réside dans aucune d'entre elles. C'est la forme que les trois dessinent ensemble. Nous avons déjà écrit que la confiance numérique est une orbite, pas un pilier. C'est ici que cela cesse d'être une métaphore.
Un programme est le conteneur des trois évaluations d'un déploiement. Chaque entité conserve son propre objectif gelé et sa propre pile croissante d'itérations scellées. Le programme les rassemble en un objet unique et publiquement vérifiable : un sceau de programme. Et le sceau de programme hérite de la même règle d'honnêteté, un niveau au-dessus. Sa garantie n'est pas la moyenne flatteuse de ses trois entités. C'est le minimum. Si le modèle obtient une garantie Reasonable mais que la gouvernance de l'organisation n'est encore que Limited, l'ensemble du programme est Limited, et le sceau l'indique clairement. On ne peut pas blanchir une entité faible au sein d'une moyenne forte. L'orbite n'est digne de confiance qu'à la hauteur de son entité la moins bien observée, ce qui est exactement la vérité dont un décideur a besoin et qu'il n'obtient presque jamais.
Un seul corps n'est pas un échec
Le sceau du programme est la destination, pas le péage. En principe, un déploiement comporte trois corps, et en principe, vous devriez certifier les trois. En pratique, vous n'en verrez souvent qu'un seul. Vous obtenez un accès par requête à un modèle via une interface et rien d'autre : ni les données d'entraînement, ni les procès-verbaux de gouvernance, ni la population sur laquelle les décisions s'appliquent. Il est tentant de considérer une évaluation à un seul corps comme une évaluation faible, et de juger que tout ce qui n'est pas l'orbite complète ne vaut pas la peine d'être publié. Cette interprétation est erronée, et le cadre de référence explique déjà pourquoi.
Commençons par la distinction que la dimension de la visibilité vise à protéger : ne pas pouvoir voir quelque chose n'est pas la même chose que de voir quelque chose de mauvais. Si vous n'obteniez qu'un accès comportemental à un modèle, votre assurance serait plafonnée aux classes inférieures, et c'est normal. Mais ce plafond est une déclaration sur votre champ de vision, pas un verdict sur le sujet. Il dit : « nous n'avons pas pu aller plus loin ». Il ne dit pas : « ce système est inéquitable ». La règle R4 est précisément ce mur : le profil d'assurance est une métadonnée sur notre travail, maintenue structurellement à l'écart du résultat d'équité, afin qu'aucun lecteur ne puisse confondre une porte fermée avec une conclusion. Une note faible obtenue en raison d'un accès refusé est une information honnête d'un type spécifique. Elle indique précisément à un acheteur ou à un régulateur dans quelle mesure une affirmation repose sur la confiance plutôt que sur l'inspection, ce qu'ils ont besoin de savoir et qu'on ne leur dit presque jamais.
Un seul corps, honnêtement évalué, est déjà un produit. L'assurance financière fonctionne ainsi depuis un siècle. Un auditeur ne refuse pas de signer parce qu'il n'a pas pu auditer l'ensemble de l'économie ; il définit un périmètre, s'y tient et délivre une assurance sur ce périmètre exact et rien de plus. « Assurance limitée sur le parcours d'équité prédictive de ce modèle, en accès comportemental, sur un instantané figé » est une phrase réelle, défendable et vendable. Elle a plus de valeur qu'un « notre IA est équitable » sur papier glacé, précisément parce qu'elle indique où elle s'arrête.
Ce qui impose une correction honnête à la manière dont le sceau du programme est composé. La règle du maillon le plus faible est juste pour les corps que vous avez évalués : vous ne pouvez pas compenser une faible note de gouvernance par la moyenne avec un modèle performant. Mais elle ne doit jamais s'appliquer aux corps que vous n'avez pas évalués, car « non vu » n'est pas « vu et faible ». Traiter un corps hors périmètre comme un zéro aurait deux conséquences néfastes à la fois. Ce serait mentir, en déguisant une absence en une mauvaise note. Et cela détruirait la seule incitation sur laquelle repose tout le système, en punissant une organisation pour les parties de la chaîne qu'elle n'a pas pu ouvrir, jusqu'à ce que la décision rationnelle soit de ne rien tenter. Le sceau comporte donc deux axes, et non un seul. La couverture, qui indique quels corps sont dans le périmètre, est présentée clairement et séparément de l'assurance, qui indique à quel point chaque corps du périmètre a été bien vu. La classe composite est le minimum des corps réellement évalués ; chaque autre corps est marqué « non affirmé », ouvertement, comme une lacune plutôt que comme une note. Vous progressez ensuite sur les deux axes au fil du temps : une orbite plus large à mesure que la chaîne s'ouvre à vous, un plancher plus élevé à mesure que l'accès, les preuves et la validité s'approfondissent sur ce que vous détenez déjà.
self-sovereign identity:
identity · privacy · consent
Pourquoi c'est là tout l'enjeu
Pointer honnêtement, observer honnêtement, puis conserver honnêtement. Chacune de ces actions, prise isolément, est une bonne habitude. Ensemble, et matérialisées dans un sceau signé et infalsifiable que n'importe qui peut vérifier sans nous le demander, elles changent la nature d'une allégation de garantie. Les coordonnées de pointage et les notes de garantie voyagent à l'intérieur du sceau sous forme de champs structurés et toujours divulgués, séparés du verdict de Fairness lui-même, afin qu'un tiers puisse vérifier la qualité de l'observation sans jamais toucher aux détails des groupes protégés. Cela cesse d'être un instantané auquel on croit sur parole pour devenir un enregistrement que l'on peut auditer : voici exactement où nous avons visé, voici exactement la qualité de notre observation, voici la preuve que cela n'a pas bougé, et voici le plancher qui s'élève à chaque itération. Voilà ce que signifie accroître la confiance dans un monde numérique. Non pas une allégation plus bruyante, mais une allégation qui reste fixe assez longtemps, et qui montre ses propres limites assez clairement, pour qu'un tiers puisse s'y fier. Le sceau n'est pas un badge. C'est le reçu.
Septième partie · Ce que nous aimerions, et que nous n'obtiendrons peut-être pas
L'histoire séduisante est la suivante. La notation de l'assurance devient un langage d'approvisionnement. Les acheteurs inscrivent dans leurs contrats un niveau A2 minimum, une note de preuve E2, une sensibilité inférieure à trois points, une fenêtre de validité de moins de quatre-vingt-dix jours. Les fournisseurs qui veulent atteindre le niveau A2 commencent à exposer leurs scores. Le marché s'oriente de lui-même vers la transparence sans que personne n'ait à en appeler à la conscience. C'est une belle histoire, et nous aimerions qu'elle soit vraie.
Nous ne savons pas si ce sera le cas, et il y a de bonnes raisons de penser que non.
Divulguer une limite de détection est un désavantage concurrentiel pour le premier qui s'y risque, car dans une salle de conseil, un bilan de santé vierge et sans réserve est plus parlant qu'un bilan calibré. De nombreux acheteurs veulent un feu vert plutôt qu'une note graduée, et un système qui abolit les feux verts n'est pas de toute évidence ce que le marché demande. Les régulateurs ont tendance à spécifier le processus plutôt que la puissance statistique, de sorte qu'un régime d'attestation peut être satisfait de bout en bout sans que personne n'ait jamais à déclarer un effet détectable minimum. Et les deux niveaux d'accès supérieurs dépendent entièrement de la volonté du fournisseur, qui pour les modèles frontières tend à se fermer plutôt qu'à s'ouvrir. Un système dont les échelons supérieurs sont inaccessibles en pratique pourrait finir par ne documenter rien d'autre que son propre plafond, en permanence.
Pourquoi ouvrirait-on la porte
Tout cela dépend d'un accès que nous ne pouvons pas imposer, ce qui soulève la seule question qui détermine si le système est un vrai produit ou un joli diagramme : pourquoi une entreprise nous laisserait-elle regarder, et regarder plus en profondeur au fil du temps ?
Parce que l'accès est le seul levier que le sujet contrôle, et il fixe le plafond de la garantie la plus solide que le sujet puisse obtenir. Un signal coûteux et vérifiable, au sens de Spence, est un signal que les honnêtes peuvent se permettre et que les malhonnêtes ne peuvent pas facilement falsifier, et l'accès est précisément cela à chaque échelon. Demandez à être cru sur parole et vous obtiendrez le niveau Indicative. Ouvrez vos décisions à la mesure et vous obtiendrez le niveau Limited. Ouvrez vos décisions et vos scores de confiance et vous obtiendrez le niveau Reasonable, le terme de l'auditeur pour une étude statistique puissante et corrigée de vos résultats. Ouvrez le modèle lui-même et vous atteindrez la frontière au-delà : un test interventionnel qui ré-interroge le modèle avec un attribut inversé et confirme que le verdict n'est pas un artefact des données, la plus forte allégation possible. Chaque échelon est un signal que les malhonnêtes ne peuvent pas facilement falsifier, et chacun est visible sur le sceau. La distance entre “nous avons été audités jusqu'aux composants internes et le système a tenu bon” et “nous vous avons demandé de nous croire sur parole” cesse d'être invisible. Sur un marché où chaque fournisseur prétend déjà être équitable, l'allégation ne vaut rien et la preuve est le seul véritable atout. Le sceau est le moyen de vendre la preuve.
Et la pression pour l'adopter n'est plus négligeable. Les obligations à haut risque de l'EU AI Act s'appliquent à partir du 2 août 2026, et leur violation entraîne des amendes pouvant atteindre 15 millions d'euros ou trois pour cent du chiffre d'affaires annuel mondial, avec un plafond plus élevé de 35 millions d'euros ou sept pour cent réservé à la catégorie des pratiques interdites de la loi. Une analyse d'impact sur les droits fondamentaux s'applique déjà à la notation de crédit et à la tarification des assurances vie et santé. La ville de New York exige des audits de biais des outils de recrutement depuis 2023, et le Colorado et d'autres États suivent de près. Dans le domaine des achats, la norme ISO/IEC 42001 est passée en à peine un an d'un facteur de différenciation à un ticket d'entrée pour les achats réglementés. Dans les secteurs du capital et de l'assurance, une enquête de 2025 auprès des acheteurs d'assurance d'entreprise a révélé que plus de neuf sur dix souhaitaient une couverture pour les risques liés à l'IA générative et que deux tiers paieraient au moins dix pour cent de plus pour l'obtenir, et on ne peut pas souscrire un risque que personne n'a évalué. Et sur le marché de la confiance lui-même, une étude menée dans quarante-sept pays a révélé que quatre personnes sur cinq seraient plus disposées à se fier à un système d'IA lorsque des mécanismes d'assurance y sont attachés. Chacun de ces éléments est une raison pour laquelle la porte s'ouvre un peu plus, car un profil d'assurance déclaré et vérifiable devient ce que le régulateur, l'acheteur, l'assureur et le client demandent tous séparément. Nous le défendrions même si aucun d'entre eux ne le faisait, car un verdict sans plafond déclaré n'est pas vraiment un verdict. Simplement, nous n'avons plus à le défendre seuls.
Qui y gagne, et ce qu'il en coûte de l'ignorer
Rien de tout cela n'est abstrait, et ce n'est pas seulement le problème du fournisseur. Chaque partie prenante autour d'un modèle déployé a son propre intérêt dans l'existence d'un dossier d'assurance vérifiable, et sa propre exposition lorsqu'il n'en existe pas. Voici ce qu'un sceau déclaré apporte à chacun d'eux, et ce que chacun risque en s'en passant.
| Partie prenante | Ce qu'ils y gagnent | Ce qu'ils risquent en s'en passant |
|---|---|---|
| Conseil d'administration et direction (le déployeur) | Devoir de diligence rempli et documenté, et une réponse en cinq minutes à la question « quelle équité, mesurée comment, auditée par qui ». PwC a modélisé une valorisation jusqu'à 4 % plus élevée et des revenus jusqu'à 3,5 % plus élevés pour un programme d'IA responsable robuste par rapport à un programme axé uniquement sur la conformité ; près de six cadres sur dix affirment que cela augmente le retour sur investissement et l'efficacité. | La violation des obligations à haut risque de l'EU AI Act coûte jusqu'à 15 millions d'euros ou 3 % du chiffre d'affaires mondial, et un incident évitable de type Apple Card ou affaire des allocations familiales aux Pays-Bas se paie en réputation et en vies humaines, des années plus tard. |
| Bâtisseurs (ingénierie et science des données) | Fairness instrumentée dans le processus de livraison au lieu d'une course effrénée avant le lancement ; la désagrégation révèle ce que les agrégats masquent (Gender Shades : une précision globale de plus de 90 % masquait un écart d'erreur de 0,8 % contre 34,7 % entre les groupes) ; une bibliothèque prête à l'emploi d'interventions de pré-traitement, de traitement et de post-traitement. | Livrer cette disparité cachée ; un réentraînement coûteux après coup ; le départ discret des ingénieurs les plus intègres. |
| Risque, conformité et juridique | Des preuves prêtes pour l'audit produites comme sous-produit (EU AI Act articles 10 à 15, l'analyse d'impact sur les droits fondamentaux, ISO 42001, NYC Local Law 144) ; une limite de détection déclarée pour chaque non-conclusion ; un périmètre déclaré, afin que l'affirmation ne puisse être surinterprétée. | La conformité traitée comme un problème de recherche alors qu'il s'agit désormais d'un problème de calendrier ; un « nous utilisons l'IA de manière éthique » irréfutable qui s'effondre à la première question précise ; des enquêtes qui coûtent en honoraires et en distraction même lorsqu'elles n'aboutissent à aucune amende. |
| Fournisseur d'IA ou de modèle (la partie à qui l'accès est demandé) | L'ouverture transformée en un signal tarifé et vérifiable ; l'assurance Raisonnable comme facteur de différenciation pour remporter les appels d'offres, là où la norme ISO 42001 est désormais le ticket d'entrée ; l'exposition à la responsabilité d'agent dans l'affaire Mobley c. Workday atténuée par une véritable trace écrite. | Plafonné à Indicatif, ce qui se lit lors d'une due diligence comme « ils nous ont demandé de les croire sur parole » ; exclu des marchés publics réglementés ; exposition en tant que co-défendeur sans rien à présenter, après que le recours collectif contre Workday a été certifié au niveau national en vertu de la loi sur la discrimination fondée sur l'âge en mai 2025. |
| Régulateurs, auditeurs et superviseurs | Un profil d'assurance lisible par machine et comparable, consultable sans jamais toucher aux données de groupes protégés ; la couverture et les limites de détection déclarées, rendant la surveillance possible ; une grammaire unique pour de nombreux fournisseurs. | Une opacité persistante où des verdicts d'apparence irréprochable cachent leurs propres angles morts ; rien de comparable entre les entreprises ; une application de la loi qui arrive des années après le préjudice, comme ce fut le cas aux Pays-Bas, où le système a fonctionné pendant près d'une décennie. |
| Clients et personnes concernées | Une lecture en langage clair de la décision et une véritable voie de recours (RGPD Article 22) ; l'assurance que ce qui n'a pas été vu est déclaré, et non passé sous silence ; des préjudices moins susceptibles de se concentrer sur ceux qui sont les moins à même de les absorber. | Des refus injustifiés et des erreurs d'identification qui apparaissent des années plus tard et ne peuvent être annulés ; le logiciel d'iTutorGroup a automatiquement rejeté plus de 200 candidats plus âgés et a conclu un accord avec l'EEOC pour 365 000 dollars en 2023. |
| Investisseurs et assureurs (capital) | La gouvernance de l'IA comme une donnée lisible pour l'ESG et pour les régimes de divulgation à venir sous la CSRD et la SEC ; un système noté est un objet différent et assurable, et la demande est réelle (plus de neuf acheteurs d'assurance d'entreprise sur dix interrogés souhaitent une couverture pour les risques de l'IA générative, et deux tiers paieraient au moins 10 % de plus). | Le capital et la couverture qui ne soutiendront pas une posture invérifiable. Une étude révèle que la surdéclaration de l'IA dans un rapport 10-K est suivie de rendements anormaux cumulés inférieurs d'environ 1,6 %. |
“Un sceau transforme un « faites-nous confiance » invérifiable en un signal coûteux, vérifiable et tarifé. La partie qui effectue le travail est celle qui est rémunérée, et celle qui refuse la transparence est celle qui doit s'en justifier.”
Septième partie · Quels avantages pour qui
Ce qui est réellement vrai aujourd'hui est plus restreint, et mérite d'être énoncé avec précision. La réglementation 10-1-1 du Colorado exige des tests quantitatifs, une documentation et une attestation annuelle de la part des assureurs-vie utilisant des données externes sur les consommateurs, l'assurance automobile et l'assurance maladie ayant été intégrées dans le champ d'application de la loi et leurs règles sectorielles étant toujours en cours d'élaboration. Le bulletin modèle de la NAIC attend un programme documenté de système d'IA. L'EU AI Act place l'évaluation des risques et la tarification dans l'assurance vie et santé dans son annexe sur les risques élevés. Il s'agit d'une évolution réelle et rapide vers des allégations documentées et testables. Aucun de ces régimes n'exige que l'on précise la plus petite disparité que les tests auraient pu détecter. La direction est la bonne. La chose spécifique que cet article défend ne figure dans aucun texte de loi, et nous ne devrions pas laisser entendre le contraire.
Il existe des précédents où ce modèle a fini par s'imposer. L'assurance graduée est devenue courante dans le domaine de l'identité et de l'audit financier, dans les deux cas grâce à un mélange de conventions professionnelles et de codification ultérieure, et dans aucun des deux cas rapidement.
Donc : une proposition, pas une prévision. Nous l'adoptons unilatéralement parce que nous pensons qu'un verdict sans plafond déclaré n'est pas vraiment un verdict, et nous préférons publier une affirmation modeste qui tient la route plutôt qu'une affirmation assurée qui ne tient pas. Cela nous coûte un titre plus percutant. Nous pensons que c'est le bon compromis, et nous serions ravis d'en débattre avec quiconque pense que les notes sont erronées, les seuils arbitraires, ou que l'ensemble de l'appareil est plus précis que la science sous-jacente ne peut le supporter. Cette dernière objection est celle que nous prenons le plus au sérieux.
La confiance s'évalue, elle ne s'affirme pas. Si votre organisation déploie l'IA et souhaite que sa posture de confiance soit mesurée par un tiers indépendant, sur les plans de la Fairness, de l'explicabilité et de la gouvernance, et que le rapport indique le plafond plutôt que de le cacher, notre bêta fermée ouvrira à un groupe restreint au T3 2026. Écrivez à hello@validant.ai avec l'objet « Closed Beta » ou demandez une démo. Les places sont limitées et attribuées en fonction de l'adéquation, et non de l'ordre d'arrivée.
En résumé
La précision n'est pas une preuve. Un modèle qui prédit parfaitement n'est pas plus équitable, il a simplement cessé d'assurer qui que ce soit ; un verdict qui semble certain n'est pas prouvé, il ne fait que masquer le peu d'éléments qui ont été examinés. Un chiffre ne devient une donnée fiable que lorsque deux éléments l'accompagnent : l'objet, ce qu'il désigne, et l'examen, la qualité de cet examen. Publiez ce chiffre seul, sans ces deux éléments, et vous tomberez dans le même piège que l'assureur au début de cet article : celui de considérer un chiffre précis comme un chiffre prouvé.
“La confiance s'évalue, elle ne s'affirme pas. Une évaluation qui ne déclare pas son propre plafond a finalement affirmé quelque chose.”
La précision n'est pas une preuve
Sources et lectures complémentaires
- 01Glinz, D. (2026). La confiance numérique est une orbite, pas un pilier. validant.ai Signal.
- 02Glinz, D. (2026). L'architecture de la confiance numérique : un cadre à plusieurs niveaux pour combler le fossé de la valeur de l'IA. 2026 IEEE Swiss Conference on Data Science and AI (SDS), Zurich, pp. 60-67.
- 03Rothschild, M. and Stiglitz, J. (1976). L'équilibre sur les marchés concurrentiels de l'assurance. Quarterly Journal of Economics, 90(4), 629-649.
- 04Barry, L. et Charpentier, A. (2020). La personnalisation comme promesse : le Big Data peut-il changer la pratique de l'assurance ? Big Data & Society, 7(1).
- 05Thomas, R. G. (2017). Couverture des sinistres : pourquoi l'assurance fonctionne mieux avec une certaine sélection adverse. Cambridge University Press.
- 06Crocker, K. J. et Snow, A. (1986). Les effets sur l'efficience de la discrimination catégorielle dans le secteur de l'assurance. Journal of Political Economy, 94(2), 321-344.
- 07Landes, X. (2015). À quel point l'équité actuarielle est-elle équitable ? Journal of Business Ethics, 128(3), 519-533.
- 08Prince, A. E. R. and Schwarcz, D. (2020). La discrimination par proxy à l'ère de l'intelligence artificielle et du Big Data. Iowa Law Review, 105(3).
- 09Barocas, S. and Selbst, A. D. (2016). L'impact disparate du Big Data. California Law Review, 104, 671-732.
- 10Chouldechova, A. (2017). Prédiction équitable avec impact disparate. Big Data, 5(2), 153-163.
- 11Kleinberg, J., Mullainathan, S. and Raghavan, M. (2017). Compromis inhérents dans la détermination équitable des scores de risque. ITCS 2017.
- 12Lee, J. D. et See, K. A. (2004). La confiance dans l'automatisation : concevoir pour une dépendance appropriée. Human Factors, 46(1), 50-80.
- 13Ji, Z., et al. (2023). Étude sur l'hallucination dans la génération de langage naturel. ACM Computing Surveys, 55(12).
- 14Ribeiro, M. T., Singh, S. and Guestrin, C. (2016). « Pourquoi devrais-je vous faire confiance ? » : Expliquer les prédictions de n'importe quel classifieur. KDD 2016.
- 15Lundberg, S. M. and Lee, S.-I. (2017). Une approche unifiée pour l'interprétation des prédictions de modèles. NeurIPS 2017.
- 16Turpin, M., Michael, J., Perez, E. and Bowman, S. R. (2023). Les modèles de langage ne disent pas toujours ce qu'ils pensent. NeurIPS 2023.
- 17International Auditing and Assurance Standards Board. ISAE 3000 (Revised).
- 18Institut national des normes et de la technologie. (2017). Lignes directrices sur l'identité numérique. NIST SP 800-63-3.
- 19Moore, D. A. et Healy, P. J. (2008). Le problème de l'excès de confiance. Psychological Review, 115(2), 502-517.
- 20Altman, D. G. et Bland, J. M. (1995). L'absence de preuve n'est pas la preuve de l'absence. BMJ, 311, 485.
- 21Joint Committee for Guides in Metrology. Évaluation des données de mesure — Guide pour l'expression de l'incertitude de mesure (JCGM 100, GUM) ; et ISO 5725, Exactitude (justesse et fidélité) des résultats et méthodes de mesure.
- 22Cour de justice de l'Union européenne. (2011). Test-Achats, C-236/09.
- 23Division des assurances du Colorado. SB21-169 and Regulation 10-1-1.
- 24Union européenne. (2024). AI Act, Règlement (UE) 2024/1689 : Article 99, sanctions et Article 113, dates d'application ; texte officiel sur EUR-Lex.
- 25PwC. (2025). Quantifier la valeur de l'IA responsable et Enquête américaine 2025 sur l'IA responsable : de la politique à la pratique.
- 26Gillespie, N., Lockey, S., et al. (2025). Confiance, attitudes et utilisation de l'intelligence artificielle : une étude mondiale 2025. KPMG et Université de Melbourne.
- 27L'Association de Genève. (2025). Risques de l'IA générative pour les entreprises : explorer le rôle de l'assurance.
- 28Buolamwini, J. et Gebru, T. (2018). Gender Shades : disparités de précision intersectionnelles dans la classification commerciale du genre. PMLR 81, 77-91.
- 29Commission américaine pour l'égalité des chances en matière d'emploi. (2023). iTutorGroup va payer 365 000 $ pour régler un procès de l'EEOC pour discrimination à l'embauche.
- 30Mobley v. Workday, Inc. (N.D. Cal., 2025). Analyse par Holland and Knight de la certification de l'action collective de mai 2025 ; dossier sur le Civil Rights Litigation Clearinghouse.
- 31Département de la protection des consommateurs et des travailleurs de la ville de New York. Outils automatisés de décision en matière d'emploi, loi locale 144.
- 32Organisation internationale de normalisation. (2023). ISO/IEC 42001 : Système de management de l'intelligence artificielle.
- 33Union européenne. (2016). RGPD Article 22, Règlement (UE) 2016/679.
 RechercheOuvrir pour lire
La confiance numérique est une orbite, pas un pilier
La confiance n'est pas un pilier de plus à ajouter. C'est l'orbite que trois corps tracent ensemble : le modèle, la personne et l'organisation. Découvrez pourquoi le problème à trois corps est la métaphore la plus juste pour une IA digne de confiance, et comment savoir où vous vous situez sur cette orbite.
Lire RechercheOuvrir pour lire
Le problème de confiance que personne n'ose nommer
Tout le monde investit dans l'IA, mais presque personne ne peut dire ce que cela lui a rapporté. Un nouvel article, récompensé par le Best Paper Award lors de la IEEE Swiss Conference on Data Science and AI, nomme cet écart et démontre qu'il s'agit d'un problème de confiance déguisé en problème technique : sept mécanismes, une architecture à quatre couches, un iceberg sous-jacent et cinq principes de conception pour le combler.
Lire RechercheOuvrir pour lire
Quand un modèle devient une munition
Un modèle d'IA de pointe a été désactivé dans le monde entier sur la base d'une simple lettre du gouvernement. Analyse de l'arrêt de juin 2026 à travers le prisme du problème des trois corps de la confiance numérique : comment le « kill switch » a cessé d'être une métaphore, pourquoi le laboratoire le plus gouvernable a été gouverné avec le moins de soin, et ce que la dépendance à un fournisseur et une juridiction uniques coûte désormais à un conseil d'administration.
Lire