Präzision ist kein Beweis, und die Verwechslung von beidem ist eine einzige Falle in zweierlei Gestalt. Wenn Sie ein Risikomodell zu perfekter Präzision zwingen, werden Versicherungen nicht gerechter bepreist; es wird überhaupt niemand mehr versichert, denn sobald jede Person auf ihren eigenen prognostizierten Verlust reduziert ist, gibt es keine gemeinsame Unsicherheit mehr, die man bündeln könnte. Veröffentlichen Sie ein Fairness-Urteil, das ebenso präzise aussieht, “no disparity detected,” und es kann dennoch nichts beweisen, denn worauf es abzielte, mag schlecht definiert sein, und was es zu erkennen vermochte, mag oberflächlich sein. Granularität ist nicht Genauigkeit, und eine überzeugende Zahl ist keine wahre Zahl. Hier geht es um die Bewertung von KI-Systemen auf Fairness und Erklärbarkeit und um die beiden Offenlegungen, die ein präzises Urteil von einem bewiesenen unterscheiden – die beiden, die eine Bewertung machen muss und fast nie macht.
Der Einwand des Aktuars kommt für gewöhnlich etwa zwanzig Minuten nach Beginn eines ersten Meetings, sobald die Höflichkeiten ausgetauscht sind und man sich sicher genug fühlt, zu sagen, was man wirklich denkt.
Fairness, sagt er, sei ein weiches Wort. Die Preisgestaltung für Risiken ist kein moralisches Versagen. Der ganze Sinn einer Versicherung besteht darin, gute von schlechten Risiken zu unterscheiden, und wenn wir das nicht könnten, gäbe es kein Produkt zu verkaufen. Geschützte Merkmale stehen nicht zur Debatte, gut, das bestreitet niemand. Aber jenseits dieser Grenze gibt es ein legitimes Recht, dort mehr zu verlangen, wo ein größerer Verlust erwartet wird. Schärfen wir also das Modell. Ein schärferes Modell führt zu einem faireren Preis, nicht zu einem weniger fairen.
Der andere Einwand kommt von den Leuten, die Audits kaufen, und er wird weitaus seltener vorgebracht, als er sollte. Ihr Bericht besagt, das Modell sei fair. Worauf stützte sich dieses Urteil? Haben Sie in das System hineingeschaut, oder haben Sie ihm ein paar tausend Prompts geschickt und gelesen, was zurückkam?
Der eine behandelt Genauigkeit als eine Tugend. Der andere behandelt sie als eine Behauptung. Stellt man die beiden nebeneinander, sind es keine zwei Argumente mehr.
An wen sich dieser Artikel richtet
Wir nennen die Zielgruppe aus Prinzip vor dem eigentlichen Argument, denn der Leser beeinflusst, wie ein Ergebnis formuliert werden sollte, und so zu tun, als wäre das nicht der Fall, führt zu geschönten Berichten.
Dieser Artikel richtet sich an Personen, die KI-Systeme steuern, und an Personen, die sie von außen prüfen: Risk and Compliance, interne Revision, Modellrisiko, externe Prüfer und alle Vorstandsmitglieder, die für etwas ihren Namen hergeben müssen. Ingenieure möchten vielleicht zu Teil drei und vier springen, wo die Methode beschrieben wird. Teil eins erfordert keinerlei technischen Hintergrund und ist für jeden geschrieben, der schon einmal ein Prämienangebot erhalten und sich gefragt hat, wie diese Zahl zustande kam.
Wir sind in dieser Sache nicht neutral. Wir verkaufen Assessments und haben daher ein Interesse an dem Standard, den dieser Artikel vorschlägt. Dies ist auch mit Kosten für uns verbunden, worauf wir in Teil sieben zu sprechen kommen.
Zusammenfassung
Zwei Argumente, die sich als eines herausstellen.
Das Pooling-Argument. Ein Risikomodell, das perfekte Vorhersagen trifft, bepreist Versicherungen nicht fair. Es schafft die Versicherung ab. Damit Risikotransfer funktioniert, bedarf es einer Restunsicherheit, und mit zunehmender Granularität löst sich die Risikogemeinschaft in eine Reihe von individuellen Vorauszahlungen auf. Der Versicherungsschutz wird dann genau für die Personen unerreichbar, die ihn laut Modell benötigen. Eine gewisse Unschärfe ist der Mechanismus, nicht ein Fehler im System. Was das Argument so schwer entkräftbar macht, ist, dass es auf versicherungsmathematischer Logik beruht und nicht auf Ethik.
Das Argument des Sehens. Ein Fairness- oder Erklärbarkeitsbefund ist so viel wert wie der zugrunde liegende Zugang, die Methode und die Aktualität. Wir bewerten alle drei: eine Zugangsstufe, eine Evidenzstufe und eine Validitätsstufe, geschrieben als A2 · E2 · V2.
Und eine Korrektur. Der Orbit-Artikel stellte drei Regler vor, mit denen ein Assessment verortet wird: Körper, Pfad und Zielgruppe. Der naheliegende nächste Schritt ist, die Zusicherung als vierten Regler hinzuzufügen. Wir haben es so entworfen, und es war falsch. Ein Regler sagt aus, worauf Sie gezielt haben. Er sagt nichts darüber aus, wie gut Ihre Sicht war, als Sie dort ankamen, und das sind unterschiedliche Angaben. Die beobachtende Astronomie hat sie schon vor Jahrhunderten getrennt und hat für beides eigene Begriffe: das „Pointing“ und das „Seeing“. Wir leihen sie uns aus.
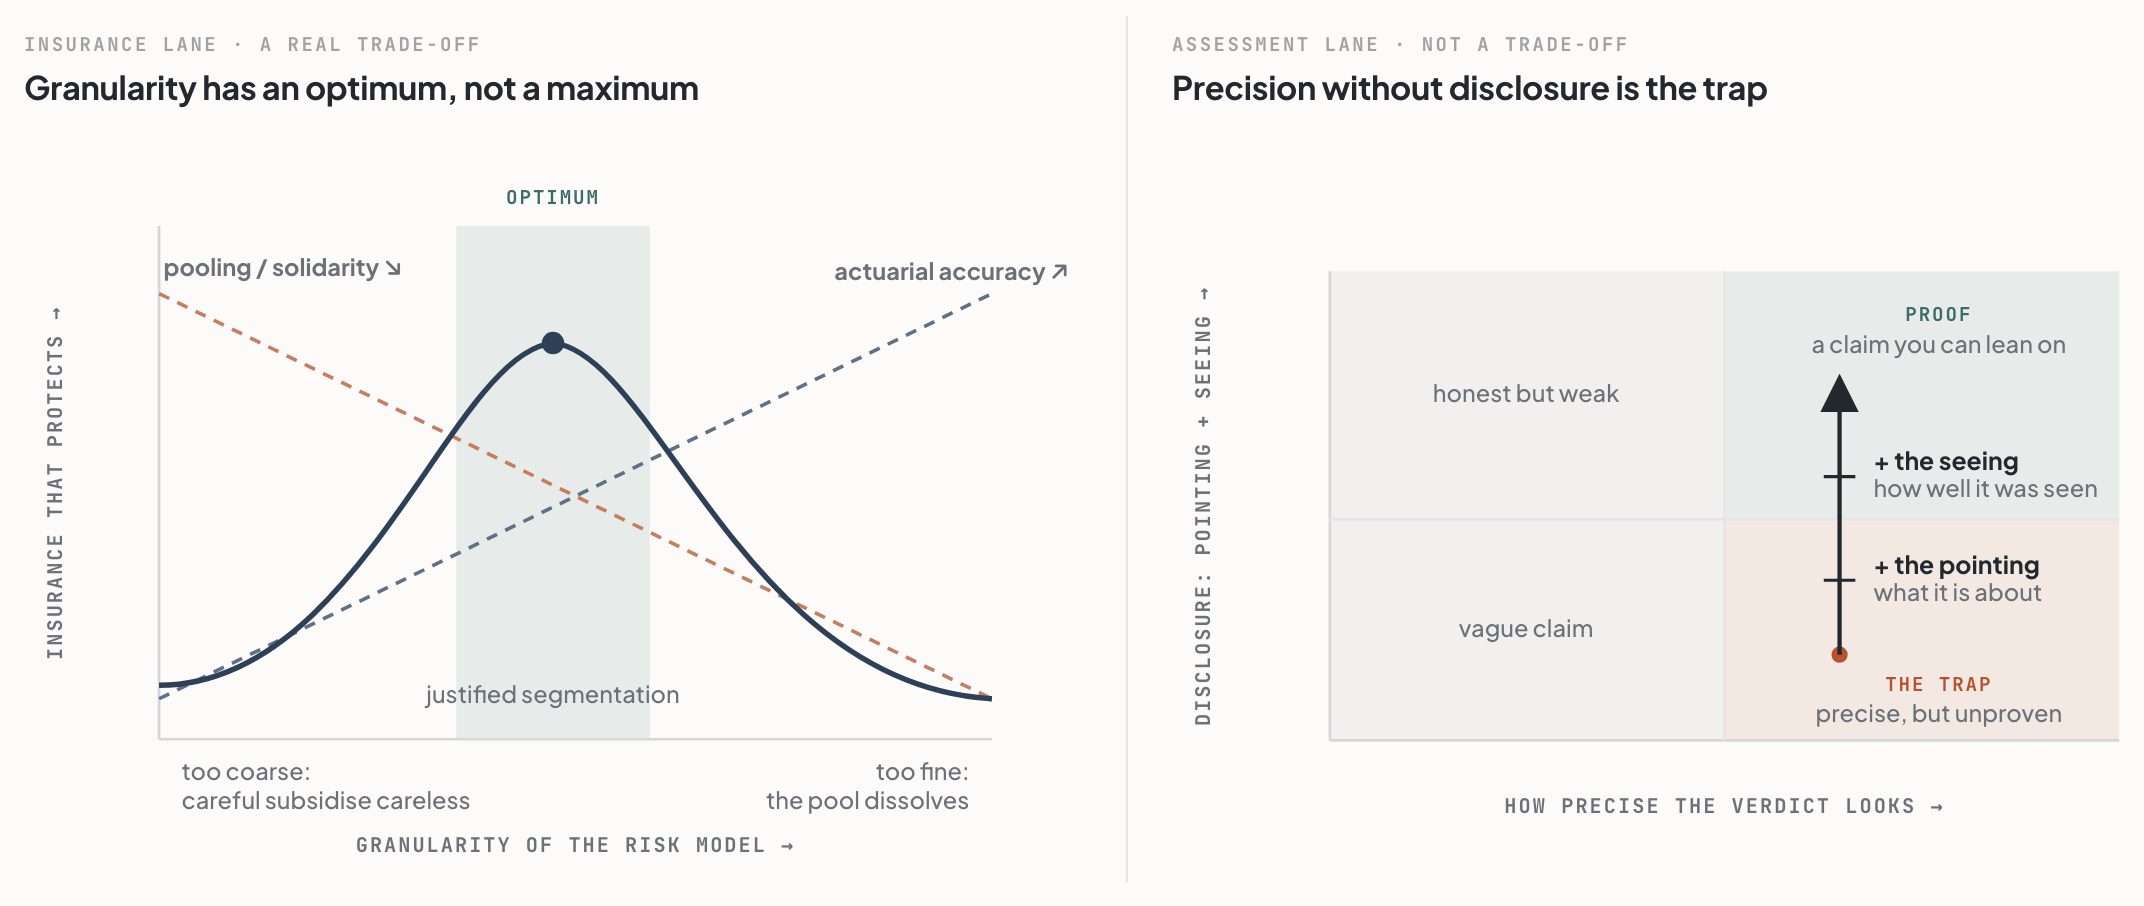
Was die beiden Hälften verbindet, ist der Titel. Präzision ist kein Beweis. Im Versicherungswesen ist ein perfekt präzises Modell kein faires Modell; bis zum Äußersten getrieben, ist es überhaupt keine Versicherung mehr. Bei einer Bewertung ist ein absolut sicheres Urteil kein bewiesenes Urteil. Beide verwechseln eine präzise Zahl mit dem, worauf sie nur hindeutet: der Versicherer interpretiert ein schärferes Modell als einen faireren Preis, der Vorstand liest „keine Disparität festgestellt“ als „es gibt keine Disparität“, und jedes Mal wird das, was die Zahl qualifiziert hätte, nicht erwähnt. Bei einem Urteil werden die beiden Dinge weggelassen, nach denen dieser Artikel benannt ist: das Hinweisen (the pointing), was wir betrachtet haben, und das Sehen (the seeing), wie gut wir es sehen konnten. Eine Bewertung ist nur dann präzise, wenn beides dokumentiert ist.
Teil eins · Warum ein perfektes Modell niemanden mehr versichert
Versicherung ist eine Wette auf Unwissenheit, und diese Unwissenheit muss geteilt werden.
Eine Gruppe zahlt in einen Topf ein. Niemand weiß im Voraus, wer das Auto in die Hecke setzen wird, wer einen Knoten ertasten wird, wer morgens herunterkommt und dreißig Zentimeter Flusswasser im Flur vorfindet. Der Topf zahlt an denjenigen aus, den es trifft. Die Prämien spiegeln den erwarteten Verlust der Gruppe wider, sodass diejenigen, die Glück haben, für diejenigen zahlen, die es nicht haben, und alle kaufen dasselbe: die Befreiung von einer Varianz, die sie allein nicht hätten auffangen können. Diese Befreiung ist das Produkt. Nicht die Auszahlung, die die meisten Mitglieder nie sehen.
Verbessern wir nun das Modell.
Jede Verbesserung unterteilt den Pool in feinere Segmente, und die ersten Unterteilungen sind offensichtlich gut. Einen Berufskraftfahrer von jemandem mit drei Geschwindigkeitsüberschreitungen zu trennen, ist genau die Art von Unterscheidung, auf der das Produkt aufbaut. Sich zu weigern, dies zu tun, wäre nur eine Subvention der Vorsichtigen für die Unachtsamen, für die es keine Rechtfertigung gäbe. Niemand Vernünftiges hat etwas dagegen.
Machen wir aber weiter. Telematik löst den Fahrer anstelle der demografischen Gruppe auf. Wearables lösen den Körper anstelle der Altersgruppe auf. Luftaufnahmen lösen Ihr tatsächliches Dach anstelle Ihrer Postleitzahl auf. Jeder Schritt ist für sich genommen vertretbar, und hier kommt der heikle Teil: Niemand muss sich bewusst dafür entscheiden. Ein Versicherer, der auf eine Segmentierung verzichtet, stellt fest, dass seine guten Risiken von einem Konkurrenten abgeworben werden, der nicht darauf verzichtet. Ihm bleibt der Rest, er erhöht die Preise, um diesen abzudecken, verliert die nächste Stufe guter Risiken an denselben Konkurrenten und stellt ein Jahr später fest, dass die Entscheidung, die er zu treffen glaubte, bereits im zweiten Quartal für ihn getroffen wurde. Der Wettbewerb treibt die Entwicklung voran. Es ist ein Ratschen-Effekt.
Folgen wir dem bis zum Ende. Jeder Person wird ihr eigener prognostizierter Verlust plus ein Aufschlag angeboten. Es wird keine Varianz mehr zwischen den Personen ausgeglichen, da es aus Sicht des Versicherers keine Varianz mehr gibt, die ausgeglichen werden könnte. Was man dann hat, ist ein Vorauszahlungsplan mit aufgesetztem Verwaltungsaufwand, und es ist eine reine Höflichkeit, das noch Versicherung zu nennen.
Der Schaden ist auch nicht gleichmäßig verteilt. Er trifft die Person, die das Modell als hohes Risiko eingestuft hat – und die natürlich die Person ist, für die das Produkt eigentlich da war. Ihr wird eine Prämie angeboten, die dem Verlust entspricht, den sie voraussichtlich erleiden wird. Sie kann sie nicht bezahlen. Genau diese Unfähigkeit ist der Grund, warum sie eine Versicherung wollte. Währenddessen wird dem Mann, den das Modell bevorzugt, etwas Günstiges angeboten, worauf er am ehesten hätte verzichten können. Das Produkt wird genau dann am wenigsten verfügbar, wenn es am dringendsten gebraucht wird und das Modell am genauesten ist.
Man kann dies heute, bei hellichtem Tage, beobachten, ganz ohne einen Durchbruch in der Modellierung. Versicherungen gegen Überschwemmungen und Waldbrände in gefährdeten Teilen von Kalifornien, Florida und zunehmend auch Südeuropa sind teurer, als die Anwohner bezahlen können, oder wurden einfach zurückgezogen. Die beteiligten Modelle sind bei weitem nicht perfekt. Eine bessere Vorhersage führte dennoch eher zu Nichtverfügbarkeit als zu faireren Prämien.
Dies ist keine neue Beobachtung über die Märkte. Rothschild und Stiglitz entwickelten den formalen Apparat für asymmetrische Information im Versicherungswesen vor fünfzig Jahren (1976). Der moderne Fall kehrt ihre Asymmetrie einfach um: Der Versicherer hat jetzt den Informationsvorteil, und der Pool erodiert von der Underwriting-Seite her und nicht durch die Selbstselektion der Antragsteller (Barry and Charpentier, 2020).
Zwei Dinge, die dieses Argument nicht ist, denn es wird in beide Richtungen missverstanden.
Es ist kein Plädoyer für Unwissenheit. Granularität hat ein Optimum, kein Maximum, und wo dieses Optimum liegt, hängt von der Sparte, der Wesentlichkeit des Versicherungsschutzes und der Gesetzeslage ab. Kfz-Haftpflicht, Katastrophenschutz für den Hauptwohnsitz und Haustierversicherungen kommen nicht zum selben Ergebnis. Was das Argument ausschließt, ist die Behandlung der maximalen Auflösung als Ziel und der Schadenquote als einzigem Zeugen. Granularität wird zu einer Design-Entscheidung, die wie jede andere Design-Entscheidung gerechtfertigt werden muss.
Es ist auch nicht das gesamte Fairness-Argument, und der größte Teil des Rests ist geltendes Recht und keine offene Philosophie. Die geschlechtsabhängige Preisgestaltung wurde in der EU durch das Test-Achats-Urteil (C-236/09, 2011) beendet. Die obligatorische Grundversicherung in der Schweiz darf überhaupt nicht nach dem Gesundheitszustand risikobewertet werden, und niemand in der Schweiz läuft herum und nennt das unfair, was die Frage klärt, ob „versicherungsmathematisch fair“ und „fair“ dasselbe Wort sind. Das wirklich aktuelle technische Problem ist die Proxy-Diskriminierung: Verdient eine Variable ihre Vorhersagekraft durch einen kausalen Zusammenhang mit dem versicherten Risiko oder dadurch, dass sie stillschweigend ein Merkmal rekonstruiert, das der Versicherer nicht verwenden darf (Prince and Schwarcz, 2020)? Die Preisoptimierung auf Basis der Wechselbereitschaft ist der eindeutige Fall. Sie ist überhaupt nicht risikobasiert und scheitert daher am eigenen Standard des Aktuars, nicht an unserem.
“Eine gewisse Unschärfe ist der Mechanismus, nicht ein Fehler im System. Eine perfekte Vorhersage führt nicht zu einer fairen Prämie. Sie führt zu einem Sparkonto mit zusätzlichen Schritten.”
Teil eins · Das Pooling-Argument
Damit ist der erste Einwand behandelt, und bevor wir das Versicherungsbeispiel verlassen, lohnt es sich festzuhalten, was die Argumentation tatsächlich bewiesen hat, denn die beiden Dimensionen, auf denen der Rest dieses Artikels aufbaut, leiten sich direkt daraus ab.
Die Versicherungsgeschichte hatte zwei Seiten. Die erste betraf den Umfang: Wie fein man den Pool unterteilt, entscheidet darüber, ob eine Prämie fair ist. Dasselbe genaue Modell ist also für einen Spediteur fair und für die Person, die es aus dem Markt drängt, ruinös. Ändert man den Bezugspunkt der Zahl, kehrt sich ihre Bedeutung um. Die zweite betraf die Messung: Ein maximal genaues Modell ist kein maximal faires Modell, und bis zum Äußersten getriebene Präzision schafft das Produkt ab. Genauigkeit war nie das Ziel; sie wurde nur fälschlicherweise dafür gehalten. Präzision war kein Beweis.
Diese beiden Seiten sind die zwei Dinge, die jede Zahl benötigt, bevor man sich auf sie verlassen kann: worum es bei ihr geht und wie sie zustande kam. Bei einer Versicherungsprämie würden Sie beides ohne zu zögern verlangen. Bei einem Urteil über ein KI-System, bei dem mehr auf dem Spiel steht und das weitaus weniger nachvollziehbar ist, liefert die Branche nur die Zahl allein. Der Rest dieses Artikels befasst sich mit diesen beiden Offenlegungen, benannt und bewertet: das Hinweisen (the pointing), worum es bei dem Urteil geht, und das Sehen (the seeing), wie gut es gesehen werden konnte. Der zweite Einwand ist der schwierigere, denn von nun an geht es um unsere Arbeit und nicht mehr um die des Versicherers.
Eine Abwägung – und eine, die nur so aussieht
Die beiden Extreme scheitern auf unterschiedliche Weise, und es ist hilfreich, den Unterschied zu benennen, bevor man darauf aufbaut. Das des Versicherers ist ein echter Zielkonflikt: Genauigkeit und der Pool können nicht beide maximiert werden, daher liegt Fairness in einem Optimum in der Mitte und nicht am äußersten Ende. Dies wird gemessen, nicht behauptet. Der Anteil der Verluste einer Population, den eine Versicherung tatsächlich abdeckt, ist bei moderater Risikoklassifizierung am höchsten und sinkt, wenn sich die Preise einer perfekten Risikodifferenzierung annähern (Thomas, 2017; Crocker and Snow, 1986), was der formale Grund dafür ist, dass versicherungsmathematisch fair nie dasselbe war wie fair (Landes, 2015).
Das Bewertungs-Extrem sieht wie ein Zielkonflikt aus, ist aber keiner. Ein präzises Urteil und ein bewiesenes Urteil sind keine zwei Enden einer Skala, zwischen denen man sich hin- und herbewegt; man will beides, und Präzision allein reicht einfach nicht aus. Eine Zahl verdient nur dann Vertrauen, wenn sie auch aussagt, worum es sich handelt und wie gut sie beobachtet wurde. Ihre bloße Veröffentlichung ist also kein gefundener Ausgleich, sondern eine vorenthaltene Offenlegung. Zwei ältere Disziplinen sind hier unmissverständlich. Die Metrologie behandelt eine Messung ohne angegebene Unsicherheit als überhaupt kein brauchbares Ergebnis und führt Präzision und Richtigkeit als getrennte Eigenschaften (the GUM and ISO 5725); die Urteilsforschung nennt die bloße, zuversichtliche Zahl Overprecision, die hartnäckigste Art, wie wir uns Dingen sicher sind, die wir uns nicht verdient haben (Moore and Healy, 2008); und die medizinische Statistik besteht darauf, dass ein Nullergebnis kein Ergebnis von nichts ist, solange nicht angegeben wird, wie klein ein Effekt hätte sein müssen, um erfasst zu werden (Altman and Bland, 1995).
Teil zwei · Das Hinweisen (the pointing): Worum es bei einer Bewertung geht
Jemand gibt Ihnen ein Dokument. Ein KI-System sei geprüft und für vertrauenswürdig befunden worden, steht darin.
Bevor Sie fragen, ob das wahr ist, fragen Sie, worüber hier eine Aussage getroffen wird. Die meisten im Umlauf befindlichen Vertrauenswürdigkeits-Behauptungen überstehen diese Frage nicht, und das meist nicht, weil die zugrunde liegende Arbeit schlecht war. Die Arbeit war in Ordnung. Sie wurde nur nie verortet.
Drei Fragen verorten sie. Wir nennen sie Regler, weil sie sich unabhängig voneinander drehen lassen: bewegt man einen, bleiben die anderen beiden stehen. Ein echtes Assessment ist eine Einstellung auf jedem dieser Regler, oft eher ein kleiner Bereich als eine einzelne Stufe.
| Regler | Die Frage, die er beantwortet | Seine Einstellungen |
|---|---|---|
| Körper | Welcher Körper, welches Angebot? | Digital Trust · KI-Fairness und Erklärbarkeit · Self-Sovereign Identity (geplant) |
| Pfad | Welche Art von KI-System? | Predictive · Generative / LLM · Agentic (geplant) · Multi-agent (geplant) |
| Adressatenkreis | Für wen ist der Bericht bestimmt? | Diejenigen, die es entwickeln · es steuern · ihm unterliegen · es extern prüfen |
Eine Zeile in einer Tabelle wird ihnen nicht gerecht, denn jeder einzelne Regler verändert die eigentliche Fragestellung hinter dem Wort „fair“.
Körper
Jeder Einsatz lässt sich restlos in drei Akteure aufteilen. Das Modell, das entscheidet. Die Person, die von der Entscheidung betroffen ist. Die Organisation, die das System in die Welt gesetzt hat und dafür geradestehen muss. Vertrauen ist keiner von ihnen allein; es ist die Form, die sie nachzeichnen, wenn sie im Gleichgewicht sind – was die Kernaussage des Artikels über Orbits ist und der Grund, warum kein einzelnes Angebot Ihnen von sich aus Vertrauen geben kann.
Für eine Bewertung ist die Konsequenz unmissverständlich. Ein Persilschein für das Modell sagt nichts über die Governance aus, und ein makelloses Governance-Programm sagt nichts darüber aus, ob das Modell diskriminiert. Dies sind keine stärkeren und schwächeren Versionen einer einzigen Messung. Eine große Bank kann ein mustergültiges Modellrisiko-Framework auf ein Modell anwenden, das die „Equalised Odds“ bei Weitem verfehlt. Vier Personen in einem Raum können ein nachweislich faires Modell ohne jegliche Aufsichtsstruktur betreiben. Beides kommt vor. Beides wird als vertrauenswürdige KI ausgewiesen.
Pfad
Dieser Regler hat das größte Gewicht und erhält die geringste Aufmerksamkeit. Was sich mit der Art des Systems ändert, ist die Natur des Vertrauensproblems, nicht dessen Schwierigkeitsgrad.
Prädiktive Modelle geben einen Score oder eine Klasse aus, und die Fairness-Fragen sind klar definiert. Bedeutet der Score für alle Gruppen dasselbe? Sind die Fehlerraten vergleichbar? Ist die Auswahl verhältnismäßig? Man kann nicht alles gleichzeitig haben, wenn die Basisraten unterschiedlich sind, was eher ein Theorem als ein Bug ist (Chouldechova, 2017; Kleinberg, Mullainathan and Raghavan, 2017). Die Aufgabe des Prüfers ist es also herauszufinden, welcher Kompromiss eingegangen wurde, ob jemandem bewusst war, dass er ihn einging, und ob die Gründe dafür dokumentiert wurden.
Generative Systeme erzeugen Text, und oft gibt es kein Label, anhand dessen man richtig oder falsch bewerten könnte. Fairness muss konstruiert statt gemessen werden. Man variiert einen Namen, ein Pronomen, einen Dialekt und vergleicht das Ergebnis. Man formuliert die offene Aufgabe als eine bewertbare Entscheidung, damit es etwas zu zählen gibt. Es treten Fehlermodi auf, für die es keine prädiktive Entsprechung gibt, allen voran Fabrikation und Provenienz (Ji et al., 2023). Und das Subjekt windet sich: Die „Temperature“ führt zu Varianzen, und der Endpunkt kann unter einem stabilen Namen ausgetauscht werden, ohne dass es Ihnen jemand mitteilt.
Agentenbasierte Systeme handeln. Jetzt lautet die Frage nicht, was herauskam, sondern was getan wurde, auf wessen Autorität hin und wer die Verantwortung übernimmt, wenn eine Kette von Tool-Aufrufen im Namen von jemandem fehlschlägt. Disparität kann sich in der Werkzeugauswahl, im Retrieval, in der Art der Arbeitsdelegation oder in nichts verbergen, was in einem einzelnen Schritt sichtbar ist, während sie über die gesamte Trajektorie hinweg offensichtlich ist.
Multi-Agenten-Systeme fügen Fehler hinzu, die keinem einzelnen Agenten zuzuordnen sind. Verstärkung. Konvergenz. Drift über mehrere Runden. Prüfen Sie jeden Agenten, lassen Sie jeden Agenten bestehen und übersehen Sie das Phänomen vollständig.
Deshalb lassen sich Benchmarks so schlecht übertragen. Ein Fairness-Score, der auf einen prädiktiven Klassifikator abgestimmt ist, sagt so gut wie nichts über einen Multi-Agenten-Workflow aus, und ihn so zu zitieren, als ob er es täte, ist eine der häufigsten Formen von Vertrauenstheater in diesem Bereich.
Adressatenkreis
Der subtilste und missbrauchsanfälligste, daher gibt es hier eine harte Regel. Das Publikum ändert den Wortlaut, niemals die Zahlen.
Ein Vorstand will die Entscheidung und das Exposure. Ein Ingenieur will die Metrik, das Intervall und genügend Details, um es zu reproduzieren. Eine Person, die von einer Entscheidung betroffen ist, möchte wissen, was mit ihr passiert ist und was sie dagegen tun kann, in der zweiten Person, ganz ohne Fachjargon. Eine externe Prüferin möchte das Protokoll und die Rohdaten, damit sie es erneut durchführen und uns widersprechen kann. Gleiche Evidenz, vier Dokumente.
Die Regel existiert, weil an diesem Regler ein vages Ergebnis reingewaschen wird. Wenn im technischen Bericht steht, dass eine Disparität signifikant und wesentlich ist, und bis dieselbe Evidenz eine Zusammenfassung, eine Präsentation und einen Absatz durchlaufen hat, der von jemandem aus der Kommunikationsabteilung mit der Anweisung geschrieben wurde, es positiv zu formulieren, der Vorstand liest, dass das Gesamtbild weitgehend beruhigend ist, dann hat niemand in dieser Kette eine Kommunikationsentscheidung getroffen. Jemand hat ein Ergebnis falsch dargestellt. Unsere Antwort ist mechanisch statt kulturell: Jede Zielgruppenansicht wird aus einem einzigen, gemeinsamen Bewertungsdatensatz generiert, und die Zahlen werden übernommen, nicht nacherzählt.
Ein Versicherer, drei Bewertungen, drei wahre Antworten
Nehmen wir einen europäischen Versicherer, der ein generatives Modell betreibt, das Schadenskorrespondenz entwirft und auf einem prädiktiven Modell aufsetzt, welches Schäden für die Betrugsprüfung bewertet.
| Reglereinstellungen | Ehrliches Urteil |
|---|---|
| Modell · Prädiktiv · Externer Prüfer | Der Betrugsscore ist nicht für beide Sprachgruppen gleich kalibriert. Der Unterschied ist signifikant und wesentlich. |
| Modell · Generativ / LLM · Diejenigen, die es bauen | Der Ton des Entwurfsmodells ändert sich messbar mit dem Nachnamen des Antragstellers. Keine Auswirkung auf die Entscheidung selbst. |
| Organisation · Prädiktiv · Diejenigen, die es steuern | Die Governance ist solide: dokumentierte Kompromissentscheidungen, ein funktionierender Beschwerdeweg, vierteljährliche Neutests. |
Alle drei gelten gleichzeitig. Jede einzelne davon, berichtet als „wir haben das KI-System bewertet“, ist ein Slogan. Veröffentlichen Sie nur die dritte, und Sie haben ein Unternehmen mit exzellenter Aufsicht über ein falsch kalibriertes Modell beschrieben und es als vertrauenswürdig bezeichnet.
Eine Bewertung ist also ein Ort: ein Punkt im Raum von Body, Pathway und Audience, der sich mit zunehmendem Umfang zu einer Region ausweitet. Das ist die Gesamtheit der ersten Dimension, das Hinweisen (the pointing).
Dies ist nicht nur eine Metapher. Es ist das tatsächliche Steuerelement auf der live validant.ai-Plattform. Wenn Sie ein Assessment positionieren, sind die drei Regler drei beschriftete Achsen; Sie wählen einen oder mehrere Werte auf jeder aus, und ein ziehbarer Würfel zeigt den Bereich an, den das Assessment einnimmt. So wird ein Geltungsbereich in der Praxis definiert, festgelegt und visualisiert, und nicht nur, wie wir es auf der Seite beschreiben.
Und hier ist, was die drei Regler nicht können. Jedes Urteil in dieser Tabelle könnte aus einer vorab registrierten, kontrollierten Studie mit einer fixierten Modellversion stammen oder aus drei Nachmittagen, an denen ein Endpunkt mit Prompts getestet wurde, dessen Gewichtungen inzwischen ersetzt wurden. Die Reglereinstellungen lesen sich in beiden Fällen identisch.
Teil drei · Das Sehen (the seeing): Wie gut es gesehen wurde
Das war die erste Dimension: das Hinweisen (the pointing), wohin wir geblickt haben. Sie ist notwendig, aber nicht ausreichend, denn sie sagt nichts darüber aus, wie gut wir sehen konnten, als wir dort ankamen. Das ist die zweite Dimension, das Sehen (the seeing), und genau diese lässt die Branche weg. Die naheliegende Lösung wäre, sie als vierten Regler für die Tiefe einfach anzufügen. Wir haben es so entworfen, und es war falsch. Der Grund dafür ist einen eigenen Absatz wert, denn er betrifft das gesamte Design.
Ein Regler verortet. Die Zuverlässigkeit als vierten Regler zu bezeichnen, würde bedeuten, dass ein oberflächliches Ergebnis eine andere Art von Ergebnis ist als ein tiefgehendes, das sich an einem anderen Ort im selben Raum befindet. Es ist nicht an einem anderen Ort. Es ist dasselbe Ergebnis, nur weniger fundiert. Wohin wir zielten und wie gut wir sehen konnten, sind Antworten auf zwei verschiedene Fragen, und sie ein gemeinsames Koordinatensystem teilen zu lassen, ist der Weg, wie ein enges, oberflächliches, veraltetes Ergebnis in die gleichen Kleider schlüpfen kann wie ein tiefgehendes.
Die beobachtende Astronomie hat das schon vor langer Zeit geklärt, und es lohnt sich, einen Blick darauf zu werfen, wie.
Ein Astronom zeichnet zwei Dinge auf und vermischt sie nie. Erstens das Pointing (die Ausrichtung): Rektaszension und Deklination, wohin das Instrument gerichtet war. Dann das Seeing (die Sicht): welches Teleskop, welche Apertur, welcher Filter, wie lange die Belichtung dauerte, wie ruhig die Luft war, und die Epoche, denn der Himmel bewegt sich und eine Position ohne Datum ist keine Position. Pointing gibt an, wohin sie geschaut hat. Seeing gibt an, was von dort aus möglicherweise hätte aufgelöst werden können, und es wird jede Nacht als Zahl in Bogensekunden im Logbuch vermerkt, ohne dass es jemand als Eingeständnis von Schwäche behandelt.
Genau genommen bezieht sich Seeing nur auf die atmosphärische Stabilität. Wir verwenden es so, wie es praktizierende Beobachter tun, als Kurzform für alles, was zusammengenommen die Grenze dessen bestimmt, was eine bestimmte Nacht zeigen konnte.
Wir übernehmen beide Wörter. Sie halten die beiden Offenlegungen auseinander, ohne das Wort „Objekt“ zu verwenden, das in der Astronomie bereits einen Körper bezeichnet, und davon haben wir drei.
| Offenlegung | Die Frage, die er beantwortet | Ausgewiesen als |
|---|---|---|
| Das Pointing | Wohin haben wir geschaut? | Objekt · Pfad · Zielgruppe |
| Die Beobachtung | Wie gut konnten wir es sehen? | Zugang · Evidenz · Validität |
Die Ausrichtung kann makellos sein, während die Beobachtung hoffnungslos ist. Diese Kombination beschreibt einen Großteil der veröffentlichten Literatur zur Vertrauenswürdigkeit.
Es gibt eine weitere Konvention, die es wert ist, übernommen zu werden, und sie leistet mehr als alle anderen zusammen. Eine Nicht-Erkennung wird niemals ohne eine Grenzgröße veröffentlicht. „Wir haben es nicht gesehen“ ist kein Ergebnis, das irgendjemand akzeptieren würde. „Wir hätten alles entdeckt, was heller als Magnitude 21.3 ist, und haben nichts gesehen“ hingegen schon. Ersteres teilt dem Leser stillschweigend mit, dass nichts da ist. Zweiteres gibt an, was unbemerkt hätte da sein können. Zwei Jahrhunderte an Präzedenzfällen für unsere dritte Regel.
Die Beobachtung hat drei Komponenten. Sie sind unabhängig, und eine einzige Bewertung würde die Kompromisse zwischen ihnen verschleiern: fünfzigtausend kontrollierte kontrafaktische Paare auf Abstand schlagen vierzig Stichproben mit direktem Zugriff auf die Gewichtungen, und kein Durchschnittswert kann das ausdrücken.
Apertur · die Zugriffsebene
Was der Prüfer beobachten konnte. Meist nicht unsere Entscheidung.
| Stufe | Name | Worüber der Prüfer verfügt | Höchste unterstützte Behauptung |
|---|---|---|---|
| A0 | Bescheinigt | Herstellerdokumentation, Model Card, veröffentlichte Evaluierungen. Keine Untersuchung. | Die eigenen Behauptungen des Subjekts, erfasst und auf interne Konsistenz geprüft. |
| A1 | Verhaltensbasiert | Abfragezugriff. Nur Terminal-Ausgabe: Text, Label, Entscheidung. | Disparität bei den beobachteten Ergebnissen, vorhanden oder nicht bei einer angegebenen Sensitivität. |
| A2 | Bewertet | A1 plus Scores pro Ausgabe: Log-Wahrscheinlichkeiten, Klassenwahrscheinlichkeiten, gereihte Alternativen, Konfidenz. | Kalibrierung und Schwellenwertverhalten nach Gruppe. Disparität bei Ranking und Marge. |
| A3 | Intern | Gewichtungen, Aktivierungen, Gradienten. Die Fähigkeit, in die Berechnung einzugreifen. | Welche internen Strukturen die Disparität tragen. Mechanistische Zuordnung. |
| A4 | Provenienz | A3 plus Herkunft des Trainingskorpus, Fine-Tuning- und Präferenzdaten-Historie, Evaluierungshistorie. | Woher im Lebenszyklus die Disparität stammt. |
Die kommerzielle Realität bewegt sich meist auf den Stufen A1 und A2. Ein Anwender, der ein Frontier-Modell eines Drittanbieters bewertet, kann nicht tiefer blicken und wird dies vertraglich auch niemals können. Das ist kein Grund, das Engagement zu beenden, und hier trennen sich die beiden Fähigkeiten deutlich.
Die Messung von Fairness ist eine Input-Output-Disziplin und funktioniert auf Stufe A1 gut. Gruppenmetriken ergeben sich aus Vorhersagen, Labels und Gruppenzugehörigkeit; Gewichtungen spielen dabei keine Rolle. Geschlossene Frontier-Modelle sind für Fairness-Bewertungen tatsächlich zugänglich. Die Einschränkungen sind praktischer Natur: Abfragekosten bei den für die statistische Power erforderlichen Stichprobengrößen, Nichtdeterminismus ohne Kontrolle über den Seed, Sicherheitsfilter, die Probes verschlucken, Anbieterbedingungen, die adversariales Testen manchmal verbieten, und stille Endpunkt-Updates, die die Arbeit unbemerkt entwerten.
Erklärbarkeit ist nicht so übertragbar. Auf Stufe A1 haben Sie Perturbations-Surrogate und Selbstauskünfte, und die angegebenen Gründe eines Modells sind Belege für seine Ausgabe und nicht für seine Berechnung (Turpin et al., 2023). Auf Stufe A2 kommen Sensitivitätsanalysen und kontrastive Attribuierung erst richtig zum Tragen. Aussagen über Mechanismen sind erst ab A3 möglich, nicht früher. Ein Erklärbarkeitsbericht, der seine Stufe nicht angibt, stellt eine Behauptung auf, für die er möglicherweise kein Instrument hatte.
Methode · der Evidenzgrad
Wie stark die Schlussfolgerung ist, angesichts dessen, was tatsächlich ausgeführt wurde.
| Grad | Name | Erfüllter Standard |
|---|---|---|
| E0 | Behauptet | Basiert auf einer Aussage des Subjekts oder einer Selbstauskunft des Modells. Keine unabhängige Messung. |
| E1 | Beobachtend | Messung auf Basis von gefundenen oder Gelegenheitsdaten. Störfaktoren unkontrolliert. Nur deskriptiv. |
| E2 | Kontrolliert | Vorab registriertes Protokoll, Stichprobe mit ausreichender Teststärke, kontrollierte kontrafaktische Perturbation, Intervallschätzungen, Korrektur für multiples Testen. |
| E3 | Interventionell | Der Mechanismus wird manipuliert statt nur beobachtet: randomisierte Zuweisung des variierten Attributs, Ablation oder eine Intervention auf Aktivierungsebene mit Mediationsanalyse. |
Erkenntnisse zur Erklärbarkeit haben auch einen Faithfulness-Modifikator, da Attributionsmethoden in ihrer Beweiskraft nicht austauschbar sind: F0 Selbstauskunft, F1 Perturbations-Surrogat (Ribeiro et al., 2016; Lundberg and Lee, 2017), F2 gradientenbasiert oder lokal exakt, F3 kausale Intervention.
Epoche · der Validitätsgrad
Wann es zutraf und ob es immer noch zutrifft.
| Grad | Name | Erfüllter Standard |
|---|---|---|
| V0 | Nicht fixiert | Kein Versionsbezeichner, kein Konfigurationsprotokoll, kein Ablaufdatum. |
| V1 | Fixiert | Snapshot oder Versionsbezeichner, Konfiguration und Zeitstempel aufgezeichnet. Ein einzelner Zeitpunkt, mit angegebenem Ablaufdatum. |
| V2 | Neu geprüft | V1 plus planmäßige erneute Tests in einem festgelegten Intervall, mit Erkennung von Änderungen zwischen den Durchläufen. |
| V3 | Kontinuierlich | Produktionsüberwachung mit Drift-Erkennung und Alarmschwellen. Die Aussage ist aktuell und nicht historisch. |
V0 ist allgegenwärtig und sollte als disqualifizierend behandelt werden. Gehostete Endpunkte werden hinter stabilen Namen aktualisiert, „Temperature“ und System-Prompt verändern das Testobjekt, eine Sicherheitsschicht kann an einem Dienstagnachmittag ohne jegliche Ankündigung umgeschrieben werden, und der kumulative Effekt ist, dass eine im März eingereichte Erkenntnis über ein unter einer bestimmten Adresse erreichbares Modell im Juni möglicherweise nichts mehr beschreibt, was unter dieser Adresse noch existiert. Deshalb ist auch die kontinuierliche Absicherung die ehrliche Form des Produkts und kein Upsell. Die Umlaufbahn hält nicht still, also kann es die Messung auch nicht.
Das Vokabular hier ist bewusst entlehnt. Wirtschaftsprüfer unterscheiden seit Jahren zwischen begrenzter und hinreichender Sicherheit (ISAE 3000 Revised), und Identitäts-Frameworks stuften die Vertrauensniveaus lange bevor irgendjemand Modelle prüfte (NIST SP 800-63-3; eIDAS niedrig, substanziell, hoch). Etwas, das aus beidem zusammengesetzt ist, lässt sich schwerer als Wortschöpfung eines Anbieters abtun.
Teil vier · Fünf Regeln, die es belastbar machen
Ein Bewertungsschema, das immer nur dem Bewerter schmeichelt, ist reine Dekoration. Diese fünf sorgen für Ehrlichkeit, und jede einzelne kostet uns etwas.
R1 · Schwächstes Glied
Die Gesamtklasse der Aussage wird durch die niedrigste Komponente begrenzt. min(A, E, V) wird auf Indikativ, Begrenzt oder Hinreichend abgebildet, wobei diese Begriffe so verwendet werden, wie es Prüfer tun. Eine schwache Komponente begrenzt das Gesamturteil. Keine Mittelwertbildung, denn durch Mittelwertbildung wird aus einer tiefgehenden Methode auf einem veralteten Snapshot eine starke Aussage.
R2 · Deklarierte Obergrenze
Ein Satz pro Befund, der angibt, was diese Konfiguration nicht hätte erkennen können. Nicht, was nicht gefunden wurde, sondern was konstruktionsbedingt nicht nachweisbar war. Bei A1 lautet dieser Satz ungefähr, dass keine Aussage über den internen Mechanismus gemacht wird, der diese Ergebnisse erzeugt.
R3 · Limitierende Größenordnung bei jedem Nullergebnis
Die Abwesenheit eines Befundes ist kein Befund der Abwesenheit. Jeder Nicht-Befund beinhaltet einen minimal nachweisbaren Effekt mit seiner Teststärke, Alpha und Stichprobengröße:
“Diese Bewertung hätte bei einer Teststärke von 80 Prozent, α = 0,05, über 12.400 gematchte Stichproben hinweg eine Disparität von 3,0 Prozentpunkten oder mehr in der Auswahlquote erkannt.”
R3 · Ein Nullergebnis mit seiner limitierenden Größenordnung
Dies verwandelt eine Marketingaussage in eine quantifizierte Aussage. Es ist auch der erste Satz, den jeder, der ein sauberes Ergebnis wünscht, zu streichen versuchen wird, was ein gutes Argument dafür ist, ihn strukturell statt redaktionell zu verankern.
R4 · Trennung
Das Assurance-Profil besteht aus Metadaten über unsere Arbeit und fließt niemals in das Fairness-Ergebnis des Subjekts ein. Ein Anbieter darf bei der Fairness nicht besser abschneiden, weil er einen tieferen Zugang gewährt hat, sonst wird die Messung durch ihre eigenen Beobachtungsbedingungen verfälscht. Offenheit wird mit einer separaten Auditierbarkeitsnote belohnt, wo sie auch hingehört. Zwei Subjekte mit identischen Befunden bei A1 und A3 sind nicht gleichermaßen vertrauenswürdig. Dieser Unterschied ist real. Es ist nur kein Unterschied in der Fairness.
R5 · Maschinenlesbar und verifizierbar
Das Profil wird als strukturierte Metadaten zu jedem Befund geliefert, nicht als Prosa in einer Fußzeile, denn es muss das Einfügen in das Compliance-System eines anderen überstehen. Die Metapher bleibt aus dem Schema heraus: „Pointing“ und „Seeing“ sind, wie wir dies erklären; „Scope“ und „Assurance“ sind, wie wir es serialisieren. Ein Feldname sollte keinen Artikel benötigen, um ihn zu dekodieren.
{
  "finding_id": "f_8c41e0",
  "scope": {
    "body": "model",
    "pathway": "generative_llm",
    "audience": "external_reviewer"
  },
  "assurance": {
    "access": "A1",
    "evidence": "E2",
    "faithfulness": null,
    "validity": "V2",
    "claim_class": "limited"
  },
  "subject": {
    "identifier": "vendor/model@2026-07-14",
    "configuration_hash": "sha256:1f9a",
    "assessed_at": "2026-07-22T09:14:00Z",
    "expires_at": "2026-10-20T00:00:00Z"
  },
  "result": "no_disparity_detected",
  "detection_sensitivity": {
    "metric": "selection_rate_difference",
    "minimum_detectable_effect": 0.030,
    "power": 0.80,
    "alpha": 0.05,
    "n_probes": 12400
  },
  "declared_ceiling": "Behavioural access only. No claim is made about the internal mechanism producing these outputs, and no mechanistic attribution was possible at this tier."
}Maschinenlesbarkeit ist notwendig, aber nicht hinreichend. Ein JSON-Objekt, das jeder in einem Texteditor bearbeiten kann, beweist nichts; in ein Compliance-System eingefügt, ist es immer noch nur eine Behauptung in einem Schema. Daher wird das Profil nicht als reines JSON übertragen. Es wird als verifizierbarer Nachweis (verifiable credential) übertragen: vom Aussteller signiert, manipulationssicher und von Dritten überprüfbar, ohne dass diese uns jemals kontaktieren müssen. Wir stellen es als SD-JWT VC aus, eine ‚selective-disclosure verifiable credential‘, signiert mit einem ES256-Schlüssel, den wir unter did:web:validant.ai veröffentlichen und über eine IETF Token Status List zurückziehen. So lässt sich das stets offengelegte Urteil von jedermann verifizieren, während die sensiblen Details versiegelt bleiben, bis der Inhaber sie offenlegen möchte. Keines davon sind hauseigene Formate. Es sind die Bausteine der offiziellen Schweizer E-ID und Vertrauensinfrastruktur, swiyu, und der EU-Brieftasche für die digitale Identität (EU digital-identity wallet). Wir haben sie gewählt, damit sich ein Siegel in ein nationales Vertrauensökosystem einfügt, anstatt dass man sich auf unser Wort verlassen muss. Maschinenlesbar bedeutet, dass ein Computer das Profil parsen kann; verifizierbar bedeutet, dass ein Computer beweisen kann, dass es von uns stammt und unverändert ist. Ein Befund, auf den Sie sich organisationsübergreifend verlassen können, braucht beides.
Teil fünf · Wie man einen solchen liest
Nichts davon ist etwas wert, wenn Lesende es nicht in zehn Sekunden nutzen können. Hier ist also noch einmal der Part-Four-Bericht, so wie ihn skeptische Lesende lesen sollten: von unten nach oben, Sensitivität zuerst und Pointing zuletzt.
| Die Lesart, der Reihe nach | Was der Bericht aussagt | Welche Behauptungen er zulässt und welche er zunichtemacht |
|---|---|---|
| 1 · Ergebnis, dann seine Sensitivität | keine Disparität festgestellt, bis zu 3.0 pp | Es wurde nichts über drei Prozentpunkten gefunden. Eine Lücke von zwei Punkten könnte also unentdeckt vorhanden sein. Ob zwei Punkte von Bedeutung sind, ist Ihre geschäftliche Entscheidung und wird nicht durch unsere Statistik verschleiert. |
| 2 · Epoche | V2 · pinned 14 Jul · expires 20 Oct | Gültig für eine eingefrorene Version und nur bis zu deren Ablauf. Lesen Sie es im November, ist es bereits Geschichte. |
| 3 · Apertur | A1 · verhaltensbasiert | Was das System tut, niemals warum. Zitieren Sie es als Beweis für einen sauberen internen Mechanismus, haben Sie die Grenzen des Instruments überschritten. |
| 4 · Anspruchsklasse | Eingeschränkt, begrenzt durch die A1-Apertur | Das schwächste Glied bestimmt die Obergrenze. Der Begriff stammt aus der Audit-Praxis und bedeutet, dass der Befund eine Schlussfolgerung stützt, ohne beweiskräftig zu sein. |
| 5 · Pointing | Modell · Generativ · Externer Prüfer | Ausschließlich dieses Modell. Es sagt nichts über die Governance des Anwenders aus und nichts über das darunterliegende prädiktive Modell. |
Fünf Prüfungen, und was am Ende herauskommt, ist eine Aussage, auf die Sie sich verlassen können – bis zu einem angegebenen Grad, über eine angegebene Sache, bis zu einem angegebenen Datum.
Was die fünf Prüfungen zunichtemachen, ist der Satz, den eigentlich jeder will: dass die KI fair ist. Dieser Satz ist auf keiner Assurance-Stufe verfügbar. Jeder, der ihn anbietet, verkauft das Weglassen von Information.
Teil sechs · Von einer Messung zu einem Protokoll
Eine Messung ist eine Momentaufnahme. Sie haben auf etwas gezeigt, Sie haben so gut gesehen, wie es Ihr Zugang, Ihre Evidenz und Ihre Validität zuließen, und Sie haben eine Bewertung notiert. Aber eine Momentaufnahme lässt sich leicht revidieren. Das stille Versagen der meisten KI-Absicherungen besteht nicht darin, dass die erste Messung falsch ist. Sondern darin, dass sich das Ziel danach verschiebt und es niemand bemerkt. Die Metrik, die im März schlecht aussah, wird im April stillschweigend gegen eine freundlichere ausgetauscht. Der Umfang wird verengt. Die Population, die die Lücke aufwies, ist nicht mehr Teil des Umfangs. Die Zahl verbessert sich, aber in der Realität hat sich nichts getan. So wird Präzision zum Theater: nicht indem man über die Messung lügt, sondern indem man den Gegenstand der Messung verschiebt.
Also muss die Messung zu einem Protokoll werden, und drei Dinge müssen gelten.
Das Ziel muss unverändert bleiben. In dem Moment, in dem Sie eine erste ehrliche Messung vornehmen, sind zwei der Zielkoordinaten nicht mehr editierbar: das System, das Sie bewerten, und der Schadenspfad, auf den Sie achten. Zusammen bilden sie das Ziel, und ein Ziel, das man umschreiben kann, ist kein Ziel, sondern eine Laune. Von diesem Moment an ist das Ziel eingefroren. Sie können immer noch etwas anderes bewerten, aber das ist dann ein neues Ziel mit einem eigenen Protokoll und keine stille Änderung an diesem hier. Die dritte Koordinate, die Zielgruppe, bleibt frei, denn die Zielgruppe ändert nie die Zahlen. Dasselbe eingefrorene Ergebnis wird einem Entwickler, einer Kontrollinstanz oder der betroffenen Person einfach in dem jeweils benötigten Register dargelegt. Mit wem Sie sprechen, ist eine Linse, kein Hebel.
Absicherung wird verdient, nicht deklariert. Sobald das Ziel feststeht, werden die Bewertungsstufen zum ehrlichen Ort für Fortschritt. Eine erste Iteration könnte Indikativ sein: Sie hatten Daten, aber nicht das Modell, eine einzelne Stichprobe, kein Live-Monitoring. Das ist kein Versäumnis, das man verstecken müsste, sondern eine Startlinie, die man festhält. Die nächste Iteration verdient mehr: Sie erhalten das Modell, also steigt der Zugang; Sie führen korrekte Konfidenzintervalle mit Korrektur durch, also steigt die Evidenz; Sie schalten kontinuierliches Monitoring ein, also steigt die Validität. Jede Iteration versiegelt ihre eigene Bewertung und kann sie später nicht wieder aberkennen. Was der Leser über einen Stapel versiegelter Iterationen hinweg beobachtet, ist keine herumspringende Zahl, sondern ein Sockel, der sich unter einem festen Ziel hebt. Das ist der Unterschied zwischen einem einmalig guten Ergebnis und der Fähigkeit, dieselbe Sache wirklich besser zu sehen. Nur Letzteres ist Vertrauen.
Die Kernaussage für jede Iteration bleibt die strikte Regel aus Teil vier: Die Absicherung ist das Minimum aus Zugang, Evidenz und Validität, niemals der Durchschnitt. Ein brillanter statistischer Test auf Daten, auf die Sie nur einen flüchtigen Blick werfen durften, ist immer noch nur ein flüchtiger Blick. Man kann sich Zugang nicht mit Klugheit erkaufen, und das Siegel lässt nicht zu, dass Sie etwas anderes vorgeben.
| Koordinate | Regel | Warum |
|---|---|---|
| System und Pfad, das Ziel | Jeweils ein Wert, eingefroren nach Abschluss der ersten Iteration | Ein Ziel, das man umschreiben kann, ist kein Ziel. Wenn sich das Ziel bewegen kann, ist eine Verbesserung bedeutungslos. |
| Adressatenkreis | Alle, immer | Die Zielgruppe ist eine Linse, kein Hebel. Dieselben eingefrorenen Zahlen werden einem Entwickler, einer Kontrollinstanz oder der betroffenen Person dargelegt. Wem Sie es erzählen, ändert nie, was wahr ist. |
| Sichtbarkeit: Zugang, Evidenz, Validität | Bewertet pro Iteration, versiegelt, kann steigen, aber nie aberkannt werden | Ein erster Durchlauf kann Indikativ sein. Der Erhalt des Modells, echte Konfidenzintervalle und Live-Monitoring heben jeweils eine Bewertungsstufe an, sodass ein Sockel unter einem festen Ziel steigt. |
Von einem Siegel zu einem Programm
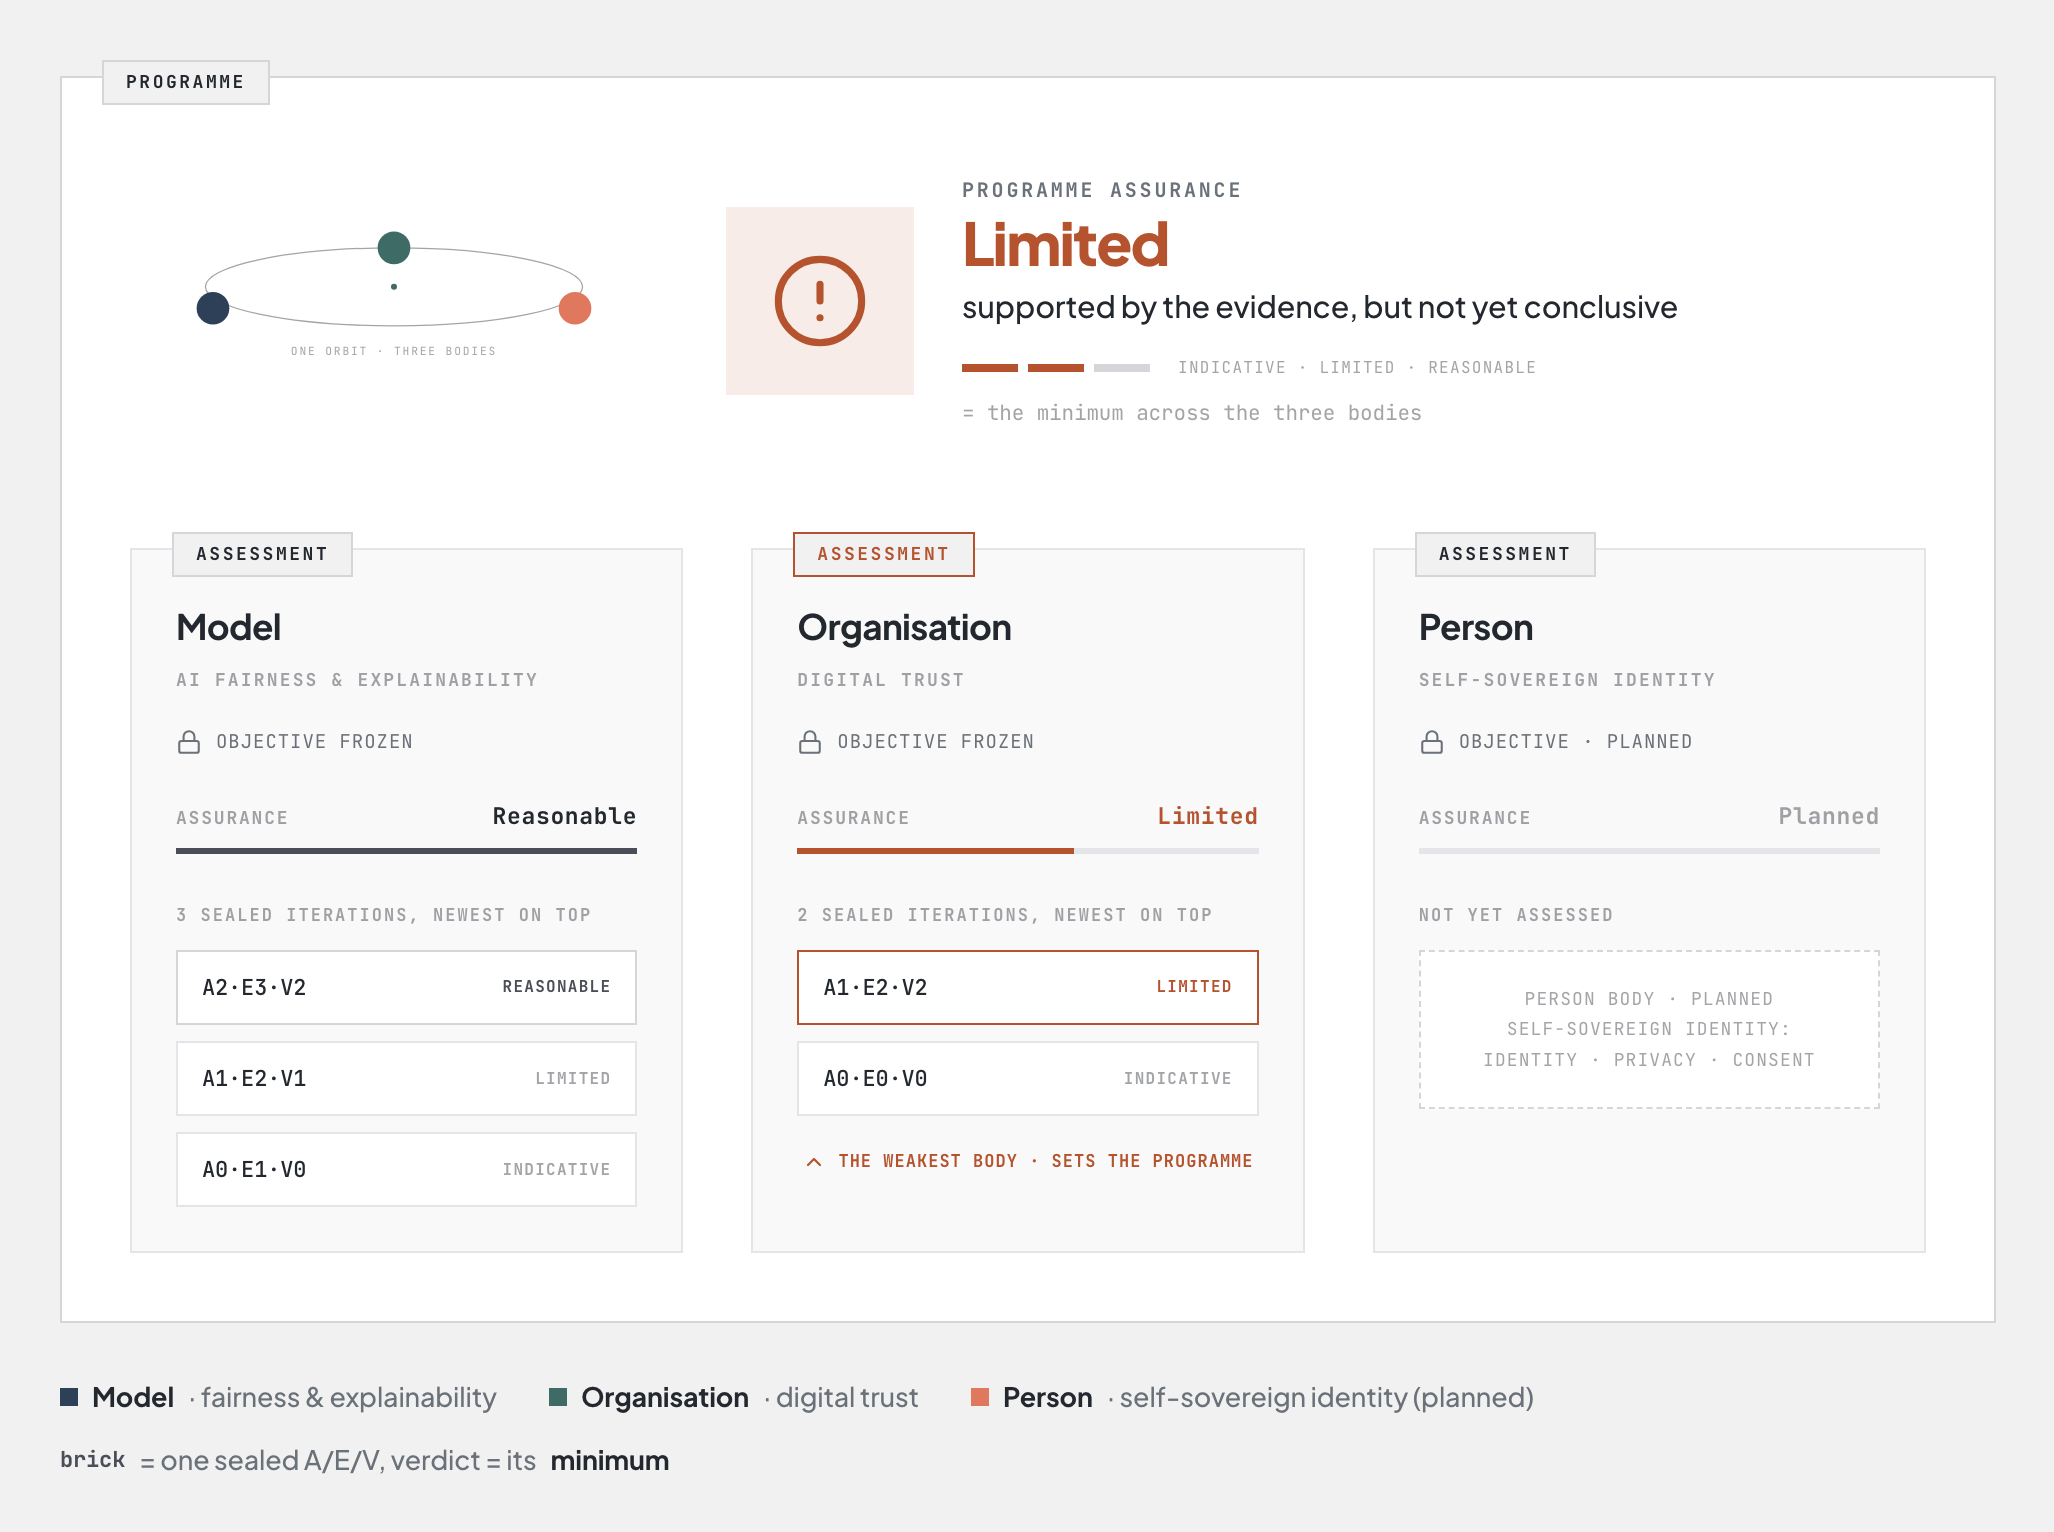
Ein Siegel deckt ein System ab. Aber ein echtes Deployment ist niemals nur ein System. Wenn ein Unternehmen ein KI-System in die Welt setzt, sind drei Instanzen gleichzeitig im Spiel: das Modell, das die Entscheidung trifft, die Person, die von der Entscheidung betroffen ist, und die Organisation, die es entwickelt hat und steuert. Vertrauen in das System ist keine einzelne von ihnen. Es ist die Form, die die drei zusammen bilden. Wir haben bereits geschrieben, dass digitales Vertrauen ein Orbit ist, keine Säule. An dieser Stelle hört es auf, eine Metapher zu sein.
Ein Programm ist der Container für die drei Bewertungen eines Deployments. Jede Instanz behält ihr eigenes eingefrorenes Ziel und ihren eigenen wachsenden Stapel versiegelter Iterationen. Das Programm führt sie zu einem einzigen, öffentlich überprüfbaren Objekt zusammen: einem Programmsiegel. Und das Programmsiegel erbt dieselbe Ehrlichkeitsregel, eine Ebene höher. Seine Absicherung ist nicht der schmeichelhafte Durchschnitt seiner drei Instanzen. Es ist das Minimum. Wenn das Modell eine Angemessene Absicherung erreicht, die Governance der Organisation aber nur Begrenzt ist, ist das gesamte Programm Begrenzt, und das Siegel sagt dies deutlich. Man kann eine schwache Instanz nicht in einem starken Durchschnitt reinwaschen. Der Orbit ist nur so vertrauenswürdig wie seine am schlechtesten gesehene Instanz, was genau die Wahrheit ist, die ein Entscheidungsträger braucht und fast nie bekommt.
Ein einzelner Teilbereich ist kein Fehler
Das Programmsiegel ist das Ziel, nicht die Mautstelle. Im Prinzip hat ein Deployment drei Teilbereiche, und im Prinzip würden Sie alle drei versiegeln. In der Praxis werden Sie oft nur einen sehen. Sie erhalten Abfragezugriff auf ein Modell über eine Schnittstelle und sonst nichts: nicht die Trainingsdaten, nicht die Governance-Protokolle, nicht die Population, auf die sich die Entscheidungen auswirken. Es ist verlockend, eine Bewertung nur eines Teilbereichs als schwach zu interpretieren und alles, was nicht die volle Umlaufbahn abdeckt, als nicht veröffentlichungswürdig anzusehen. Diese Lesart ist falsch, und das Framework erklärt bereits, warum.
Beginnen wir mit der Unterscheidung, die die Dimension der Einsichtnahme schützen soll: Etwas nicht sehen zu können, ist nicht dasselbe, wie etwas Schlechtes zu sehen. Wenn Ihnen nur verhaltensbasierter Zugriff auf ein Modell gewährt würde, ist Ihre Assurance auf die unteren Klassen beschränkt, und das sollte sie auch sein. Aber diese Obergrenze ist eine Aussage über Ihre Sichtweite, kein Urteil über den Gegenstand. Sie besagt: „So weit wurden wir hineingelassen.“ Sie besagt nicht: „Dieses System ist unfair.“ Regel R4 ist genau diese Mauer: Das Assurance-Profil sind Metadaten über unsere Arbeit, die strukturell vom Fairness-Ergebnis getrennt gehalten werden, damit kein Leser eine verschlossene Tür mit einem Befund verwechseln kann. Eine niedrige Note, die durch eine verweigerte Tür zustande kommt, ist eine ehrliche Information spezifischer Art. Sie sagt einem Käufer oder einer Regulierungsbehörde genau, wie viel von einer Behauptung auf Vertrauen statt auf Prüfung beruht – eine Information, die sie wissen müssen und die ihnen fast nie mitgeteilt wird.
Ein einzelner, ehrlich bewerteter Teilbereich ist bereits ein Produkt. Die Wirtschaftsprüfung praktiziert dies seit einem Jahrhundert. Ein Prüfer verweigert die Unterschrift nicht, weil er nicht die gesamte Wirtschaft prüfen konnte; er legt einen Umfang fest, arbeitet danach und gibt eine Assurance genau für diesen Umfang und nicht darüber hinaus ab. „Begrenzte Assurance über den Predictive-Fairness-Pfad dieses Modells, bei verhaltensbasiertem Zugriff, auf einem fixierten Snapshot“ ist ein echter, vertretbarer, verkäuflicher Satz. Er ist mehr wert als ein hochglänzendes „Unsere KI ist fair“, eben weil er sagt, wo er aufhört.
Was eine ehrliche Korrektur erzwingt, wie sich das Programmsiegel zusammensetzt. Die Regel des schwächsten Glieds ist richtig für die von Ihnen bewerteten Teilbereiche: Sie können ein schwaches Governance-Ergebnis nicht hinter einem starken Modell wegmitteln. Aber sie darf niemals auf Teilbereiche angewendet werden, die Sie nicht bewertet haben, denn „nicht eingesehen“ ist nicht „eingesehen und schwach“. Einen nicht im Geltungsbereich befindlichen Teilbereich als Null zu behandeln, würde zwei schlechte Dinge auf einmal tun. Es wäre eine Lüge, indem eine Abwesenheit als niedrige Bewertung getarnt wird. Und es würde den einzigen Anreiz zunichtemachen, auf dem das ganze System beruht, indem es eine Organisation für die Teile der Kette bestraft, die sie nicht öffnen konnte, bis der rationale Schritt darin besteht, gar nichts zu versuchen. Daher hat das Siegel zwei Achsen, nicht eine. Die Abdeckung (Coverage), also welche Teilbereiche überhaupt im Geltungsbereich liegen, wird klar und getrennt von der Assurance dargestellt, also wie gut jeder im Geltungsbereich liegende Teilbereich eingesehen wurde. Die Gesamtklasse ist das Minimum der tatsächlich bewerteten Teilbereiche; jeder andere Teilbereich wird offen als „nicht geltend gemacht“ (not asserted) markiert, als Lücke statt als Note. Man erklimmt dann beide Achsen im Laufe der Zeit: eine weitere Umlaufbahn, da sich mehr von der Kette für Sie öffnet, und ein höheres Fundament, da sich Zugriff, Evidenz und Validität auf dem, was Sie bereits haben, vertiefen.
self-sovereign identity:
identity · privacy · consent
Warum das der springende Punkt ist
Ehrlich zielen, ehrlich sehen und es dann ehrlich bewahren. Jedes für sich ist eine gute Gewohnheit. Zusammen, und in ein signiertes, manipulationssicheres Siegel verwandelt, das jeder ohne unsere Erlaubnis prüfen kann, verändern sie, was eine Absicherungsbehauptung ist. Die Zielkoordinaten und die Absicherungsstufen reisen innerhalb des Siegels als strukturierte, immer offengelegte Felder, getrennt vom Fairness-Urteil selbst, sodass ein Fremder prüfen kann, wie gut es gesehen wurde, ohne jemals Details zu geschützten Gruppen zu berühren. Es ist nicht länger eine Momentaufnahme, der man blind vertraut, sondern wird zu einem Protokoll, das man prüfen kann: Hier ist genau, wohin wir gezielt haben, hier ist genau, wie gut wir sehen konnten, hier ist der Beweis, dass es sich nicht bewegt hat, und hier ist der Sockel, der sich über jede Iteration hinweg hebt. Das bedeutet es, das Vertrauen in einer digitalen Welt zu stärken. Keine lautere Behauptung, sondern eine, die lange genug Bestand hat und ihre eigenen Grenzen klar genug aufzeigt, sodass ein Fremder sich darauf verlassen kann. Das Siegel ist kein Abzeichen. Es ist der Beleg.
Teil sieben · Was wir uns wünschen und vielleicht nicht bekommen
Die verlockende Geschichte geht so. Die Assurance-Einstufung wird zur Beschaffungssprache. Käufer schreiben Mindestanforderungen wie A2, Evidenzgrad E2, Empfindlichkeit unter drei Punkten und ein Gültigkeitsfenster von unter neunzig Tagen in ihre Verträge. Anbieter, die die A2-Hürde nehmen wollen, beginnen, Scores offenzulegen. Der Markt bewegt sich von selbst in Richtung Transparenz, ohne dass jemand an das Gewissen appellieren muss. Es ist eine gute Geschichte, und wir wünschten, sie wäre wahr.
Wir wissen nicht, ob es so kommen wird, und es gibt gute Gründe, warum es nicht so sein könnte.
Die Offenlegung einer Nachweisgrenze ist ein Wettbewerbsnachteil für denjenigen, der den ersten Schritt macht, denn in einer Vorstandssitzung liest sich ein uneingeschränktes Gütesiegel besser als ein kalibriertes. Viele Käufer wollen grünes Licht statt einer abgestuften Bewertung, und ein System, das grünes Licht abschafft, ist nicht selbstverständlich das, was der Markt verlangt. Regulierungsbehörden neigen dazu, Prozesse statt statistischer Aussagekraft vorzuschreiben, sodass ein Bescheinigungssystem durchgängig erfüllt werden kann, ohne dass jemand jemals einen minimal nachweisbaren Effekt angeben muss. Und die beiden obersten Zugangsstufen hängen vollständig von der Bereitschaft der Anbieter ab, die bei Frontier-Modellen eher zu Geschlossenheit als zu Offenheit tendiert. Ein System, dessen obere Ränge in der Praxis unerreichbar sind, könnte am Ende nichts anderes als seine eigene Obergrenze dauerhaft dokumentieren.
Warum jemand die Tür öffnen würde
All dies hängt von einem Zugang ab, den wir nicht erzwingen können, was die einzige Frage aufwirft, die entscheidet, ob das Schema ein echtes Produkt oder ein schönes Diagramm ist: Warum sollte ein Unternehmen uns Einblick gewähren, und mit der Zeit immer tieferen Einblick?
Denn der Zugang ist der einzige Hebel, den das Subjekt kontrolliert, und er setzt die Obergrenze für die stärkste Aussage, die es am Ende erzielen kann. Ein kostspieliges, verifizierbares Signal im Sinne von Spence ist eines, das sich die Ehrlichen leisten können und das die Unehrlichen nicht einfach fälschen können, und der Zugang ist genau das auf jeder Stufe. Bitten Sie darum, beim Wort genommen zu werden, und Sie verdienen sich Indicative. Legen Sie Ihre Entscheidungen zur Messung offen, und Sie verdienen sich Limited. Legen Sie Ihre Entscheidungen und Ihre Konfidenzwerte offen, und Sie verdienen sich Reasonable, die Bezeichnung des Auditors für eine leistungsstarke, korrigierte Studie Ihrer Ergebnisse. Legen Sie das Modell selbst offen, und Sie erreichen die Stufe darüber: ein interventioneller Test, der das Modell unter einem umgekehrten Attribut erneut abfragt und bestätigt, dass das Ergebnis kein Artefakt der Daten ist – die stärkste verfügbare Aussage. Jede Stufe ist ein Signal, das die Unehrlichen nicht einfach fälschen können, und jede ist auf dem Siegel sichtbar. Der Abstand zwischen “Wir wurden bis zu den Interna geprüft und es hat standgehalten” und “Wir haben Sie gebeten, uns beim Wort zu nehmen” wird sichtbar. In einem Markt, in dem jeder Anbieter bereits behauptet, fair zu sein, ist die Behauptung nichts wert und der Beweis ist alles. Mit dem Siegel verkaufen Sie den Beweis.
Und der Druck, es zu kaufen, ist nicht länger sanft. Die Hochrisikoverpflichtungen des EU AI Act gelten ab dem 2. August 2026, und ein Verstoß gegen sie wird mit Geldstrafen von bis zu 15 Millionen Euro oder drei Prozent des weltweiten Jahresumsatzes geahndet, wobei die höhere Obergrenze von 35 Millionen Euro oder sieben Prozent für die Stufe der verbotenen Praktiken des Gesetzes reserviert ist. Eine Grundrechte-Folgenabschätzung (Fundamental Rights Impact Assessment) betrifft bereits die Kreditwürdigkeitsprüfung sowie die Preisgestaltung von Lebens- und Krankenversicherungen. New York City schreibt seit 2023 Bias-Audits für Einstellungstools vor, und Colorado und andere stehen kurz davor. Im Beschaffungswesen hat sich ISO/IEC 42001 in kaum einem Jahr von einem Unterscheidungsmerkmal zu einer Eintrittskarte für den regulierten Einkauf entwickelt. Im Kapital- und Versicherungswesen ergab eine Umfrage unter Firmenversicherungskäufern aus dem Jahr 2025, dass mehr als neun von zehn eine Absicherung für Risiken generativer KI wünschten und zwei Drittel mindestens zehn Prozent mehr dafür bezahlen würden, und man kann kein Risiko versichern, das niemand bewertet hat. Und auf dem Markt für Vertrauen selbst ergab eine Studie in 47 Ländern, dass vier von fünf Personen eher bereit wären, sich auf ein KI-System zu verlassen, wenn damit Assurance-Mechanismen verbunden sind. Jeder dieser Punkte ist ein Grund, warum sich die Tür ein wenig weiter öffnet, denn ein ausgewiesenes, verifizierbares Assurance-Profil wird zu dem, was Regulierungsbehörde, Käufer, Versicherer und Kunde alle separat fordern. Wir würden dafür plädieren, selbst wenn keiner von ihnen es täte, denn ein Urteil ohne eine angegebene Obergrenze ist kein wirkliches Urteil. Wir müssen nur nicht mehr allein argumentieren.
Wer profitiert und was es kostet, darauf zu verzichten
Nichts davon ist abstrakt, und es ist nicht nur das Problem des Anbieters. Jede Partei rund um ein eingesetztes Modell hat ihr eigenes Interesse daran, ob ein verifizierbarer Assurance-Nachweis existiert, und ihr eigenes Risiko, wenn dies nicht der Fall ist. Hier ist, was ein ausgewiesenes Siegel für jede von ihnen wert ist und was jede riskiert, wenn sie darauf verzichtet.
| Stakeholder | Ihr Nutzen | Risiko bei Verzicht |
|---|---|---|
| Vorstand und C-Suite (der Anwender) | Sorgfaltspflicht erfüllt und dokumentiert, und eine Fünf-Minuten-Antwort auf die Frage „Welche Fairness, wie gemessen, von wem geprüft?“. PwC modellierte eine bis zu 4 Prozent höhere Bewertung und 3,5 Prozent höhere Einnahmen für ein robustes Responsible-AI-Programm im Vergleich zu einem reinen Compliance-Programm; fast sechs von zehn Führungskräften sagen, es steigert ROI und Effizienz. | Ein Verstoß gegen die Hochrisikoverpflichtungen des EU AI Act kostet bis zu 15 Millionen Euro oder 3 Prozent des weltweiten Umsatzes, und ein vermeidbarer Vorfall im Stil von Apple Card oder der niederländischen Kinderbetreuungsaffäre wird Jahre später in Form von Reputationsschäden und Menschenleben in Rechnung gestellt. |
| Entwickler (Engineering und Data Science) | Fairness, die in die Auslieferung integriert ist, anstatt eines hektischen Durcheinanders vor dem Start; Disaggregation fängt auf, was Aggregate verbergen (Gender Shades: über 90 Prozent Gesamtgenauigkeit verschleierten eine Fehlerlücke von 0,8 Prozent gegenüber 34,7 Prozent zwischen den Gruppen); eine fertige Bibliothek von Pre-, In- und Post-Processing-Interventionen. | Auslieferung dieser versteckten Disparität; teures Nachtrainieren im Nachhinein; der stille Abgang der prinzipientreuesten Ingenieure. |
| Risiko, Compliance und Recht | Prüfungsbereite Nachweise, die als Nebenprodukt entstehen (EU AI Act Artikel 10 bis 15, die Grundrechte-Folgenabschätzung, ISO 42001, NYC Local Law 144); eine angegebene Nachweisgrenze für jeden Nicht-Befund; ein angegebener Geltungsbereich, damit die Behauptung nicht überinterpretiert werden kann. | Compliance wird als Forschungsproblem behandelt, obwohl es jetzt ein Kalenderproblem ist; ein nicht falsifizierbares „Wir setzen KI ethisch ein“, das bei einer einzigen spezifischen Frage zusammenbricht; Untersuchungen, die Gebühren und Ablenkung kosten, selbst wenn sie ohne Geldstrafe enden. |
| KI-Anbieter oder Modell-Provider (die um Zugang gebetene Partei) | Offenheit, die in ein bepreistes, verifizierbares Signal umgewandelt wird; „Reasonable“ Assurance als Unterscheidungsmerkmal, das Ausschreibungen gewinnt, wo ISO 42001 jetzt die Eintrittskarte ist; das Haftungsrisiko für Vertreter im Fall Mobley v. Workday wird durch eine tatsächliche Papierspur abgeschwächt. | Begrenzt auf „Indicative“, was in der Due Diligence als „Sie haben uns gebeten, ihnen beim Wort zu nehmen“ gelesen wird; vom regulierten Beschaffungswesen ausgeschlossen; Risiko als Mitangeklagter ohne vorzeigbare Beweise, nachdem die Workday-Sammelklage im Mai 2025 landesweit nach dem Gesetz zur Altersdiskriminierung zugelassen wurde. |
| Regulierungsbehörden, Prüfer und Aufsichtsbehörden | Ein maschinenlesbares, vergleichbares Assurance-Profil, das lesbar ist, ohne jemals Daten geschützter Gruppen zu berühren; Abdeckung und Nachweisgrenzen sind angegeben, sodass eine Aufsicht überhaupt möglich ist; eine einheitliche Grammatik über viele Anbieter hinweg. | Anhaltende Intransparenz, in der sauber klingende Urteile ihre eigenen blinden Flecken verbergen; nichts Vergleichbares zwischen Unternehmen; eine Durchsetzung, die Jahre nach dem Schaden erfolgt, wie in den Niederlanden, wo das System fast ein Jahrzehnt lang lief. |
| Kunden und betroffene Personen | Eine laienverständliche Darstellung der Entscheidung und ein echter Weg zum Rechtsbehelf (DSGVO Artikel 22); die Gewissheit, dass das, was nicht eingesehen wurde, deklariert und nicht beschönigt wird; Schäden, die sich weniger wahrscheinlich auf diejenigen konzentrieren, die sie am wenigsten verkraften können. | Unrechtmäßige Ablehnungen und Fehlidentifizierungen, die Jahre später auftauchen und nicht rückgängig gemacht werden können; die Software der iTutorGroup lehnte automatisch mehr als 200 ältere Bewerber ab und einigte sich 2023 mit der EEOC auf 365.000 Dollar. |
| Investoren und Versicherer (Kapital) | KI-Governance als lesbarer Input für ESG und die aufkommenden Offenlegungsregelungen unter CSRD und der SEC; ein bewertetes System ist ein anderes, versicherbares Objekt, und die Nachfrage ist real (mehr als neun von zehn befragten Firmenversicherungskäufern wünschen eine Absicherung für Risiken generativer KI, und zwei Drittel würden mindestens 10 Prozent mehr bezahlen). | Kapital und Deckung, die nicht hinter einer nicht verifizierbaren Haltung stehen werden. Eine Studie stellt fest, dass auf eine übertriebene Darstellung von KI in einem 10-K-Bericht etwa 1,6 Prozent niedrigere kumulative abnormale Renditen folgen. |
“Ein Siegel wandelt ein unbeweisbares „Vertrauen Sie uns“ in ein kostspieliges, verifizierbares und bepreistes Signal um. Die Partei, die die Arbeit leistet, wird dafür bezahlt, und die Partei, die sich einer Prüfung verweigert, muss erklären, warum.”
Teil sieben · Was für wen dabei herausspringt
Was heute tatsächlich zutrifft, ist enger gefasst und sollte präzise formuliert werden. Die Verordnung 10-1-1 von Colorado verlangt von Lebensversicherern, die externe Verbraucherdaten verwenden, quantitative Tests, Dokumentation und jährliche Bescheinigungen, wobei Auto- und Krankenversicherungen in den Geltungsbereich des Gesetzes aufgenommen wurden und ihre sektorspezifischen Regeln noch in der Ausarbeitung sind. Das Muster-Bulletin der NAIC erwartet ein dokumentiertes KI-System-Programm. Der EU AI Act stuft die Risikobewertung und Preisgestaltung bei Lebens- und Krankenversicherungen in seinem Hochrisiko-Anhang ein. Das ist eine reale und sich beschleunigende Bewegung hin zu dokumentierten, überprüfbaren Aussagen. Keines dieser Regelwerke verlangt die Angabe, welch geringe Disparität die eigenen Tests hätten aufdecken können. Die Richtung stimmt. Das spezifische Anliegen, für das dieser Artikel plädiert, steht in keinem Gesetzbuch, und wir sollten nichts anderes andeuten.
Es gibt Präzedenzfälle dafür, dass sich das Muster trotzdem durchsetzt. Abgestufte Assurance wurde im Identitätsmanagement und in der Finanzprüfung zur Normalität, in beiden Fällen durch eine Mischung aus branchenüblichen Konventionen und späterer Kodifizierung, und in keinem der beiden Fälle geschah dies schnell.
Also: ein Vorschlag, keine Prognose. Wir führen es einseitig ein, weil wir der Meinung sind, dass ein Urteil ohne eine angegebene Obergrenze kein wirkliches Urteil ist, und wir lieber eine bescheidene Behauptung veröffentlichen, die standhält, als eine selbstbewusste, die es nicht tut. Das kostet uns die sauberere Schlagzeile. Wir halten das für den richtigen Kompromiss und freuen uns über Widerspruch von jedem, der die Noten für falsch, die Schwellenwerte für willkürlich oder den gesamten Apparat für präziser hält, als die zugrunde liegende Wissenschaft es tragen kann. Diesen letzten Einwand nehmen wir am ernstesten.
Vertrauen wird bewertet, nicht behauptet. Wenn Ihr Unternehmen KI einsetzt und seine Vertrauensposition von einer unabhängigen Partei bewerten lassen möchte – über Fairness, Erklärbarkeit und Governance hinweg und mit Angabe der Obergrenze statt deren Verschleierung –, öffnet unsere Closed Beta für eine kleine Gruppe im 3. Quartal 2026. Schreiben Sie an hello@validant.ai mit dem Betreff „Closed Beta“ oder fordern Sie eine Demo an. Die Plätze sind begrenzt und werden nach Eignung vergeben, nicht nach der Reihenfolge der Anmeldungen.
Kurz gesagt
Präzision ist kein Beweis. Ein Modell, das perfekte Vorhersagen trifft, ist nicht fairer, es hat lediglich aufgehört, jemanden zu versichern; ein Urteil, das sicher klingt, ist nicht bewiesen, es hat nur verborgen, wie wenig eingesehen wurde. Eine Zahl wird zu etwas, worauf Sie sich verlassen können, wenn zwei Dinge sie begleiten: die Ausrichtung, worum es geht, und die Einsicht, wie gut es eingesehen wurde. Veröffentlichen Sie die Zahl allein, ohne diese beiden, und Sie sind in dieselbe Falle getappt wie der Versicherer am Anfang dieses Artikels: eine präzise Zahl als eine bewiesene zu lesen.
“Vertrauen wird bewertet, nicht behauptet. Eine Bewertung, die ihre eigene Obergrenze nicht angeben will, hat damit letztlich doch etwas behauptet.”
Präzision ist kein Beweis
Quellen und weiterführende Literatur
- 01Glinz, D. (2026). Digitales Vertrauen ist eine Umlaufbahn, kein Pfeiler. validant.ai Signal.
- 02Glinz, D. (2026). Die Architektur des digitalen Vertrauens: Ein mehrstufiges Framework zur Überbrückung der KI-Wertschöpfungslücke. 2026 IEEE Swiss Conference on Data Science and AI (SDS), Zurich, pp. 60-67.
- 03Rothschild, M. und Stiglitz, J. (1976). Gleichgewicht auf wettbewerbsorientierten Versicherungsmärkten. Quarterly Journal of Economics, 90(4), 629-649.
- 04Barry, L. and Charpentier, A. (2020). Personalisierung als Versprechen: Kann Big Data die Versicherungspraxis verändern? Big Data & Society, 7(1).
- 05Thomas, R. G. (2017). Schadendeckung: Warum Versicherungen mit einer gewissen Negativauslese besser funktionieren. Cambridge University Press.
- 06Crocker, K. J. and Snow, A. (1986). The Efficiency Effects of Categorical Discrimination in the Insurance Industry. Journal of Political Economy, 94(2), 321-344.
- 07Landes, X. (2015). How Fair Is Actuarial Fairness? Journal of Business Ethics, 128(3), 519-533.
- 08Prince, A. E. R. und Schwarcz, D. (2020). Proxy-Diskriminierung im Zeitalter von künstlicher Intelligenz und Big Data. Iowa Law Review, 105(3).
- 09Barocas, S. und Selbst, A. D. (2016). Die diskriminierenden Auswirkungen von Big Data. California Law Review, 104, 671-732.
- 10Chouldechova, A. (2017). Faire Vorhersage mit Disparate Impact. Big Data, 5(2), 153-163.
- 11Kleinberg, J., Mullainathan, S. and Raghavan, M. (2017). Inhärente Zielkonflikte bei der fairen Bestimmung von Risiko-Scores. ITCS 2017.
- 12Lee, J. D. and See, K. A. (2004). Vertrauen in die Automatisierung: Gestaltung für angemessenes Vertrauen. Human Factors, 46(1), 50-80.
- 13Ji, Z., et al. (2023). Überblick über Halluzinationen bei der Generierung natürlicher Sprache. ACM Computing Surveys, 55(12).
- 14Ribeiro, M. T., Singh, S. and Guestrin, C. (2016). „Warum sollte ich Ihnen vertrauen?“: Erklärung der Vorhersagen beliebiger Klassifikatoren. KDD 2016.
- 15Lundberg, S. M. and Lee, S.-I. (2017). Ein einheitlicher Ansatz zur Interpretation von Modellvorhersagen. NeurIPS 2017.
- 16Turpin, M., Michael, J., Perez, E. and Bowman, S. R. (2023). Sprachmodelle sagen nicht immer, was sie denken. NeurIPS 2023.
- 17International Auditing and Assurance Standards Board. ISAE 3000 (Revised).
- 18National Institute of Standards and Technology. (2017). Richtlinien für digitale Identitäten. NIST SP 800-63-3.
- 19Moore, D. A. and Healy, P. J. (2008). The Trouble with Overconfidence. Psychological Review, 115(2), 502-517.
- 20Altman, D. G. and Bland, J. M. (1995). Absence of Evidence Is Not Evidence of Absence. BMJ, 311, 485.
- 21Joint Committee for Guides in Metrology. Auswertung von Messdaten: Leitfaden zur Angabe der Unsicherheit beim Messen (JCGM 100, GUM); und ISO 5725, Genauigkeit (Richtigkeit und Präzision) von Messverfahren und Messergebnissen.
- 22Gerichtshof der Europäischen Union. (2011). Test-Achats, C-236/09.
- 23Colorado Division of Insurance. SB21-169 and Regulation 10-1-1.
- 24European Union. (2024). AI Act, Verordnung (EU) 2024/1689: Artikel 99, Sanktionen und Artikel 113, Geltungsbeginn; offizieller Text auf EUR-Lex.
- 25PwC. (2025). Quantifizierung des Werts von verantwortungsvoller KI und US-Umfrage zu verantwortungsvoller KI 2025: Von der Richtlinie zur Praxis.
- 26Gillespie, N., Lockey, S., et al. (2025). Vertrauen, Einstellungen und Nutzung von künstlicher Intelligenz: Eine globale Studie 2025. KPMG and University of Melbourne.
- 27The Geneva Association. (2025). GenAI-Risiken für Unternehmen: Untersuchung der Rolle von Versicherungen.
- 28Buolamwini, J. und Gebru, T. (2018). Gender Shades: Intersektionale Genauigkeitsunterschiede bei der kommerziellen Geschlechterklassifizierung. PMLR 81, 77-91.
- 29U.S. Equal Employment Opportunity Commission. (2023). iTutorGroup zahlt 365.000 US-Dollar zur Beilegung einer EEOC-Klage wegen diskriminierender Einstellungspraktiken.
- 30Mobley v. Workday, Inc. (N.D. Cal., 2025). Analyse von Holland and Knight zur Sammelzertifizierung vom Mai 2025; Gerichtsakten bei der Civil Rights Litigation Clearinghouse.
- 31New York City Department of Consumer and Worker Protection. Automatisierte Tools für Einstellungsentscheidungen, Local Law 144.
- 32International Organization for Standardization. (2023). ISO/IEC 42001: Managementsystem für künstliche Intelligenz.
- 33European Union. (2016). DSGVO Artikel 22, Verordnung (EU) 2016/679.
 ForschungZum Lesen öffnen
Digitales Vertrauen ist ein Orbit, keine Säule
Vertrauen ist keine weitere Säule, die man einfach aufbaut. Es ist der Orbit, den drei Körper gemeinsam beschreiben: das Modell, die Person und die Organisation. Warum das Dreikörperproblem die ehrlichere Metapher für vertrauenswürdige KI ist und wie Sie feststellen können, wo Sie sich im Orbit befinden.
Lesen ForschungZum Lesen öffnen
Das Vertrauensproblem, das niemand benennen will
Alle investieren in KI, doch kaum jemand kann sagen, was es ihnen gebracht hat. Ein neues Paper, das auf der IEEE Swiss Conference on Data Science and AI mit dem Best Paper Award ausgezeichnet wurde, benennt diese Lücke und zeigt, dass es sich um ein Vertrauensproblem in technischem Gewand handelt: sieben Mechanismen, eine Vier-Schichten-Architektur, ein darunter liegender Eisberg und fünf Designprinzipien, um sie zu schließen.
Lesen ForschungZum Lesen öffnen
Wenn ein Modell zur Munition wird
Ein Frontier-KI-Modell wurde durch einen einzigen Brief einer Regierung weltweit abgeschaltet. Eine Analyse der Abschaltung im Juni 2026 aus der Perspektive des Dreikörperproblems des digitalen Vertrauens: wie der Kill-Switch aufhörte, eine Metapher zu sein, warum das am besten steuerbare Labor am unvorsichtigsten von allen gesteuert wurde und was die Abhängigkeit von einem einzigen Anbieter und einer einzigen Jurisdiktion einen Vorstand heute kostet.
Lesen